
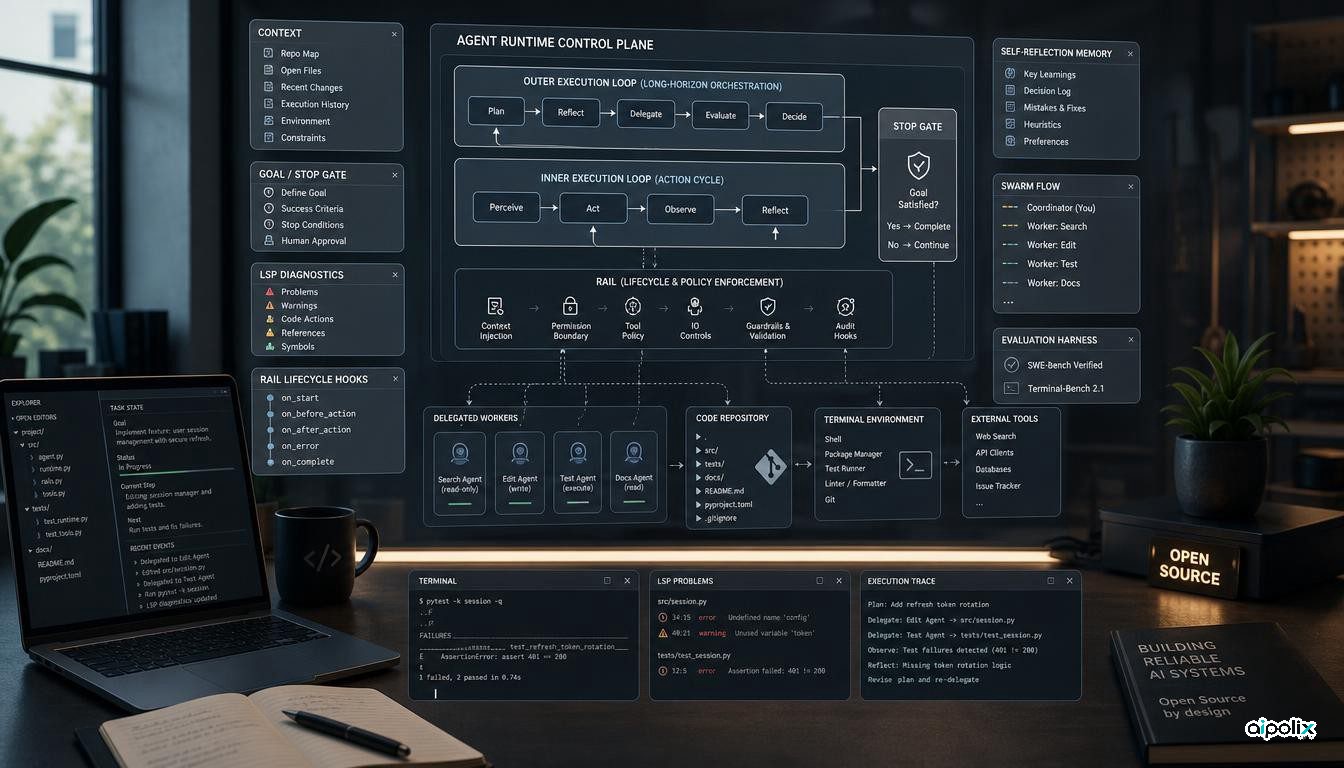
openJiuwen a publié un nouvel article de recherche qui traite le harnais d’agent de codage comme une couche système de premier rang, et non comme une enveloppe mince autour d’un modèle. Le travail compte parce que la performance de codage à long horizon dépend de plus en plus de la façon dont un harnais gère le contexte, les outils, la poursuite de la tâche, le diagnostic, la délégation et l’arrêt, et non seulement du modèle qui se trouve en dessous. L’article décrit un substrat d’exécution partagé pour agents isolés, sous-agents délégués et flux multi-agents, tandis que le dépôt public JiuwenSwarm fournit un chemin d’implémentation inspectable.
Les auteurs rapportent 82.6% sur SWE-bench Verified et 87.19% sur Terminal-Bench 2.1. Ces chiffres sont notables, mais la question d’ingénierie plus utile est ce qu’ils établissent réellement. L’article lui-même met en garde : les systèmes de classement diffèrent par les modèles, les invites, les outils et les implémentations. Cette réserve est centrale : l’enseignement le plus solide pour le praticien n’est pas qu’un harnais en a définitivement battu un autre, mais que l’orchestration est devenue une partie mesurable du système d’agent, qui exige sa propre évaluation contrôlée.
Le harnais devient un plan de contrôle
openJiuwen sépare l’exécution en une Inner Loop pour l’interaction modèle-outil et une Outer Loop pour la poursuite au niveau de la tâche. Des capacités transversales s’attachent via un mécanisme appelé Rail, qui utilise des crochets de cycle de vie et un ordre explicite, plutôt que d’enchâsser chaque capacité dans un chemin d’exécution distinct. La même sémantique d’exécution est réutilisée pour les agents autonomes, les sous-agents délégués et Swarm Flow.
Cette conception vise un vrai problème d’ingénierie. Les agents de codage accumulent désormais planification, mémoire, gestion du contexte, contrôles de sécurité, intervention humaine, nouvelles tentatives et délégation. Si chaque nouvelle capacité change la boucle d’exécution centrale, le harnais devient difficile à raisonner et plus dur à tester. Un substrat commun peut faciliter la composition de ces comportements, mais il transforme aussi la configuration du harnais en une surface de contrôle qui mérite versionnage, observabilité et tests de régression.
Le dépôt montre que le projet n’est pas seulement un article conceptuel. JiuwenSwarm expose la collaboration multi-agents, des flux de travail déterministes Swarmflow, des permissions d’outils, une exécution distribuée et un mécanisme Auto Harness visant à optimiser le harnais sans changer les poids du modèle. Le dépôt est sous licence Apache-2.0 et installable, ce qui améliore la reproductibilité par rapport à un article qui ne rapporte que des résultats de référence.
L’adaptativité à l’exécution change l’état du cadre, pas les poids du modèle
La seconde idée de l’article est l’adaptativité à l’exécution. Au lieu de réentraîner le modèle, openJiuwen modifie l’état contrôlé par le cadre à mesure que la tâche se déroule. La gestion du contexte comprime, réduit ou décharge l’information plus ancienne ; Goal Mode contrôle l’acceptation et l’arrêt ; le retour piloté par LSP injecte des diagnostics sémantiques ; l’auto-réflexion stocke une expérience réutilisable à partir de trajectoires achevées.
Cette distinction compte pour les équipes qui construisent des agents sur des modèles de tiers. Elle suggère que certaines améliorations à long horizon peuvent venir du plan de contrôle autour d’un modèle fixe, ce qui est opérationnellement plus rapide à itérer que le réglage fin. Elle crée aussi une surface de défaillance séparée. Un gestionnaire de contexte peut cacher la mauvaise preuve, une règle d’arrêt peut terminer trop tôt, et une boucle de diagnostic peut réagir trop fortement à des signaux statiques qui ne capturent pas la correction architecturale ou métier.
Pour l’évaluation en production, le harnais ne doit donc pas être traité comme une infrastructure invisible. Les équipes ont besoin de tests sur la rétention de contexte, les conditions d’arrêt, les permissions d’outils, le comportement de nouvelle tentative et l’injection de diagnostic, en plus de tester le modèle lui-même.
L’écart de titre sur la référence exige un audit de l’allégation
L’article rapporte qu’openJiuwen avec GPT-5.6 Sol atteint 87.19% sur Terminal-Bench 2.1, comparé à un résultat sélectionné du classement Claude Code de 83.8%. Lu isolément, cela ressemble à un avantage de 3.39 points de pourcentage du harnais. Ce n’est pas une estimation contrôlée de l’effet du harnais, parce que les deux systèmes utilisent des modèles d’épine dorsale différents et peuvent aussi différer par les invites, les outils et l’implémentation.
L’article inclut une comparaison plus informative à modèle apparié, en utilisant Fable 5. Dans ce cadre, openJiuwen rapporte 84.04% tandis que Claude Code rapporte 83.8%, un écart de seulement 0.24 point de pourcentage. Les auteurs disent explicitement qu’apparier le modèle réduit un facteur de confusion mais n’élimine pas les différences d’invites, d’outils ou d’implémentations d’agents.
SWE-bench Verified est un peu plus propre parce qu’openJiuwen et la comparaison sélectionnée la plus forte utilisent tous deux Claude 4.5 Opus, et openJiuwen rapporte 82.6% contre 79.2%. Même là, la comparaison reste au niveau du système plutôt qu’une ablation contrôlée du harnais. L’article reconnaît que des études plus larges et des ablations plus détaillées sont nécessaires pour isoler les contributions des mécanismes individuels.
Cela change la façon dont les résultats doivent être utilisés. La preuve de référence étaye l’allégation qu’openJiuwen est compétitif en tant que système d’agent complet. Elle n’établit pas encore que Rail, Goal Mode, l’adaptation de contexte ou tout autre mécanisme individuel cause le gain rapporté.
Ce que les équipes d’ingénierie devraient mesurer
Une évaluation utile devrait garder le modèle, l’effort de raisonnement, l’ensemble d’outils, le budget de jetons et l’environnement aussi fixes que possible, puis faire varier les composants du harnais un à un. Cela montrerait si l’adaptation de contexte, le retour LSP, la logique d’arrêt, la réflexion ou la coordination multi-agents contribuent réellement au taux d’achèvement, à la latence, au coût ou à la fiabilité.
Les équipes devraient aussi mesurer le comportement de défaillance, et non seulement les taux de réussite agrégés. Les agents à long horizon peuvent échouer en bouclant, en oubliant des contraintes, en épuisant le budget, en surutilisant les outils, en s’arrêtant avant que les critères d’acceptation soient remplis, ou en reportant un contexte périmé. Ces modes de défaillance se projettent directement sur les mécanismes de contrôle qu’openJiuwen cherche à formaliser.
L’implication pratique dépasse ce projet. L’évaluation d’agents se dirige vers une discipline de pile complète. Un score de modèle seul est insuffisant lorsque le harnais contrôle ce que le modèle voit, quels outils il peut utiliser, quand il réessaie et quand il s’arrête. L’ingénierie reproductible d’agents exigera de plus en plus des comparaisons à modèle apparié et des ablations de harnais, surtout lorsque les allégations du projet attribuent des gains à l’orchestration.
Pourquoi l’article mérite d’être suivi
openJiuwen reste une prépublication, et l’évaluation actuelle se limite à SWE-bench Verified et Terminal-Bench 2.1. Les auteurs eux-mêmes appellent à des études contrôlées plus larges sur davantage de références, de modèles et de configurations. Il n’y a pas encore de base pour traiter le système comme universellement supérieur ou éprouvé en production.
Ce qui rend le travail publiable, c’est la combinaison d’une implémentation libre inspectable, d’une architecture concrète de harnais et d’une preuve de référence qui peut être auditée plutôt que reprise à sa valeur faciale. La contribution la plus solide est le cadrage du contrôle à l’exécution comme une couche d’ingénierie que l’on peut modifier indépendamment des poids du modèle.
Pour les développeurs et les architectes, cela crée une question d’évaluation plus précise : non pas « quel modèle de codage est le meilleur ? », mais « quelle configuration modèle plus harnais produit des résultats fiables sous un budget et une frontière de contrôle fixes ? ». C’est une référence plus difficile à exécuter, mais elle est bien plus proche de la façon dont les systèmes d’agents en production se comportent réellement.
Sources
- https://arxiv.org/abs/2608.27969
- https://github.com/openJiuwen-ai/jiuwenswarm