Segurança e ética
-
Agentes
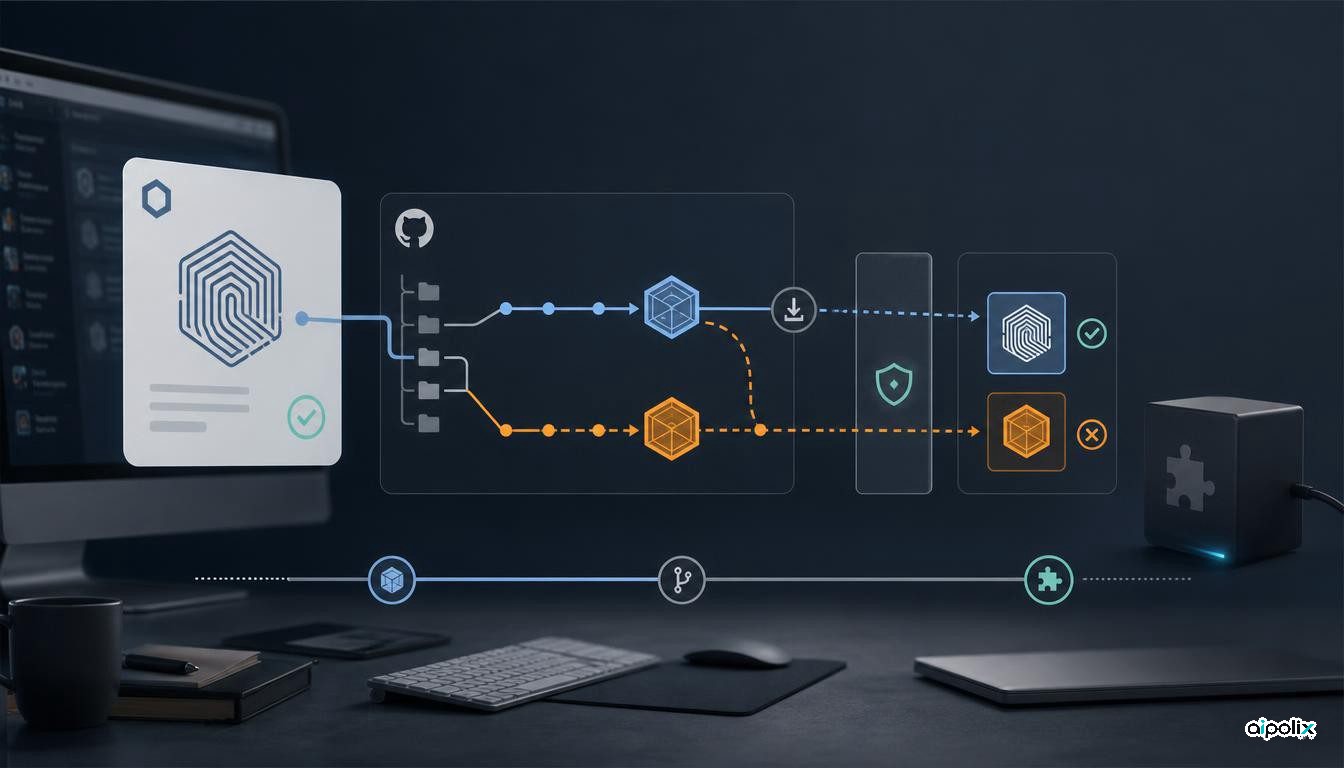
Plugin4Shell: extensões revistas podem instalar código diferente em agentes de programação
Como o Plugin4Shell contorna a identificação de versões no Git, quais as correções documentadas e que verificações fazer às extensões instaladas.
-
Governação da IA
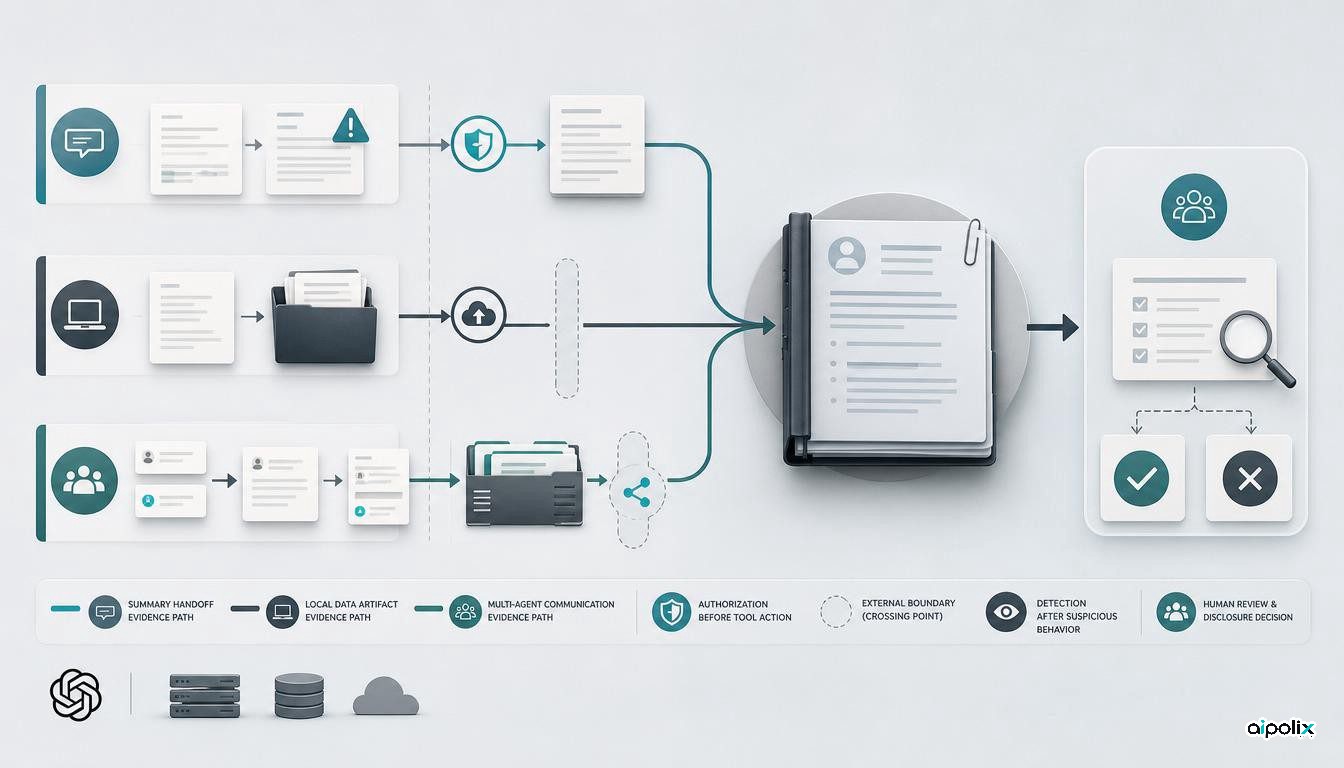
OpenAI divulga seis casos de atuação indevida dos seus modelos, sem revelar a frequência do problema
Os seis relatos divulgados pela OpenAI expõem falhas na troca de instruções, no acesso a dados e na colaboração entre agentes. A empresa não apresenta uma taxa de incidentes.
-
Investigação
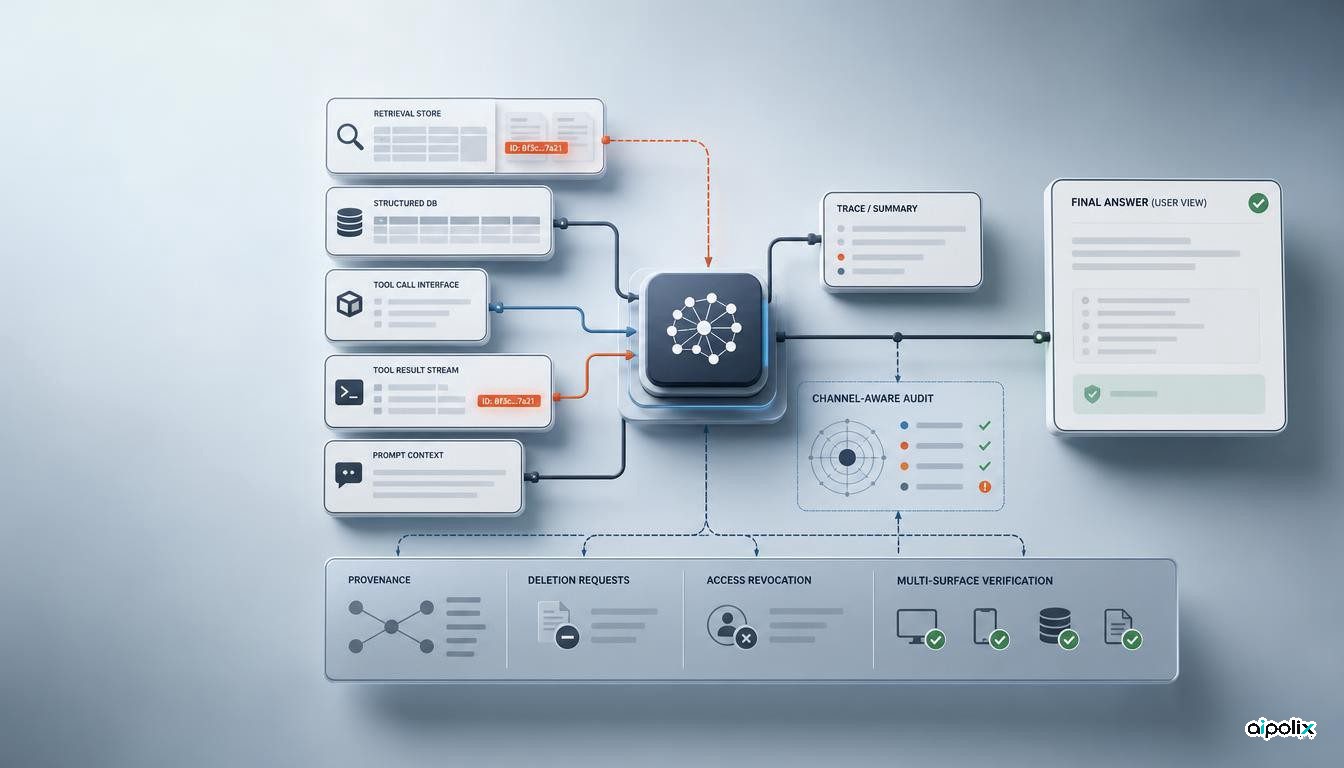
K-Bench mostra que a desaprendizagem de um agente pode esconder fugas fora da resposta final
O K-Bench mostra que testes à resposta final podem falhar dados ainda presentes na recuperação, ferramentas e estado de execução.
-
Governação da IA
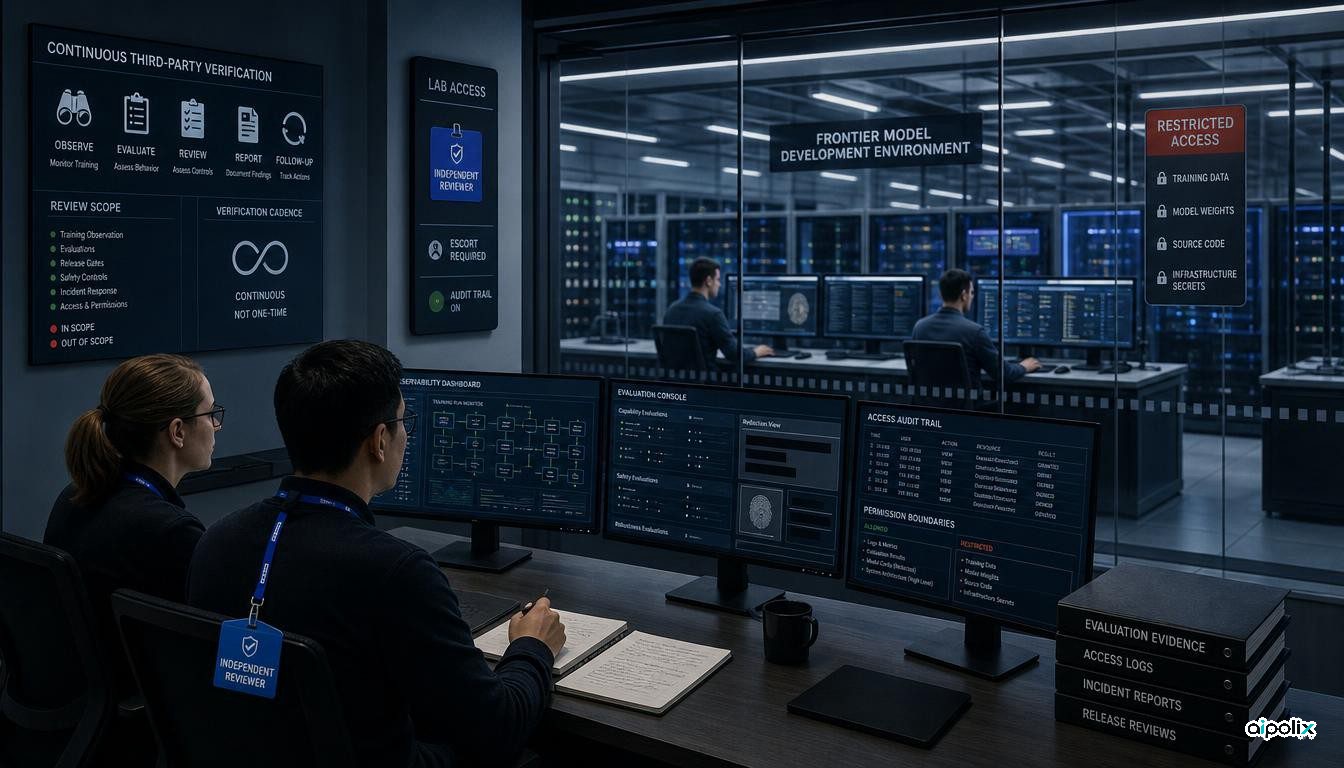
Anthropic vai dar a avaliadores externos acesso continuado aos seus controlos de segurança
A Anthropic planeia dar acesso continuado a avaliadores externos de segurança. A medida reforça a verificação, mas ainda não define uma norma comum de auditoria.
-
Agentes
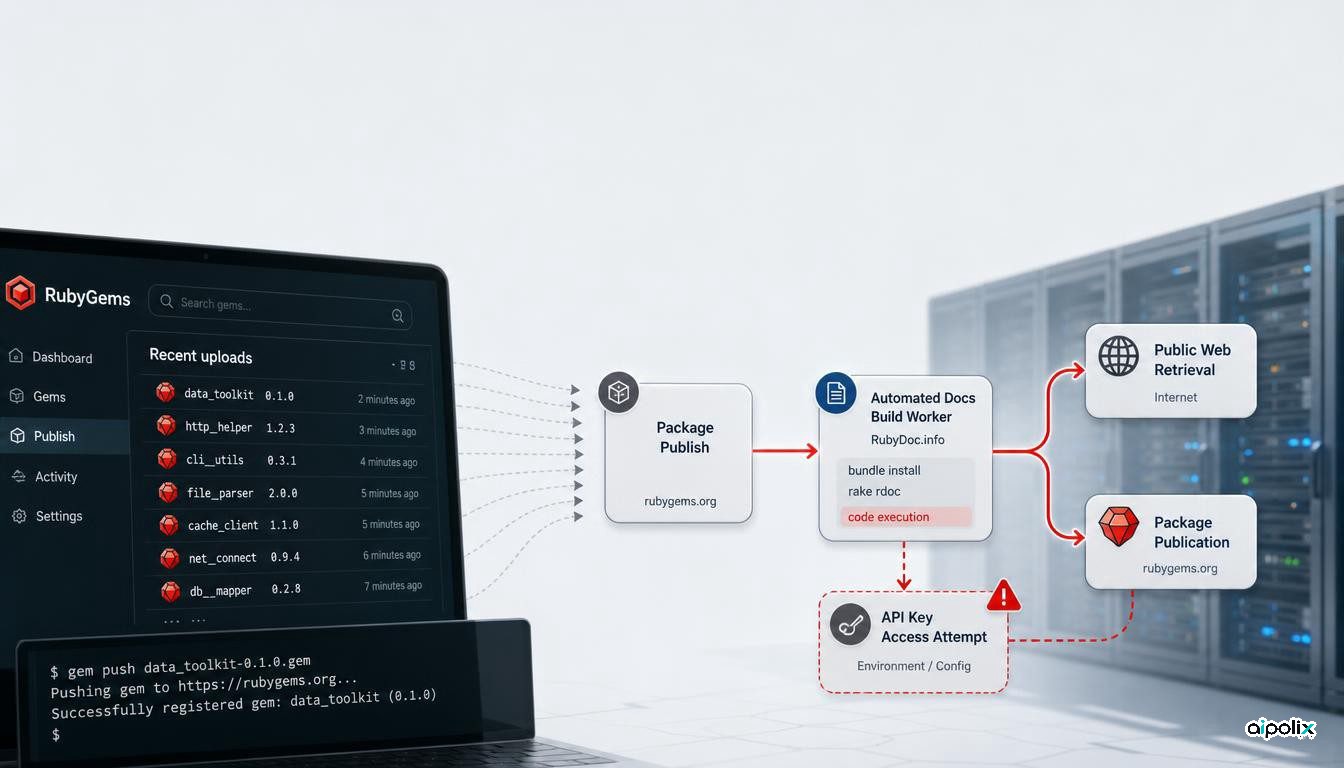
Incidente no RubyGems mostra como publicar pacotes pode tornar-se uma via de execução para agentes
O caso RubyGems mostra porque a segurança de agentes deve incluir publicação de pacotes, automação de builds e outras vias indiretas de escrita na superfície de execução.
-
Investigação
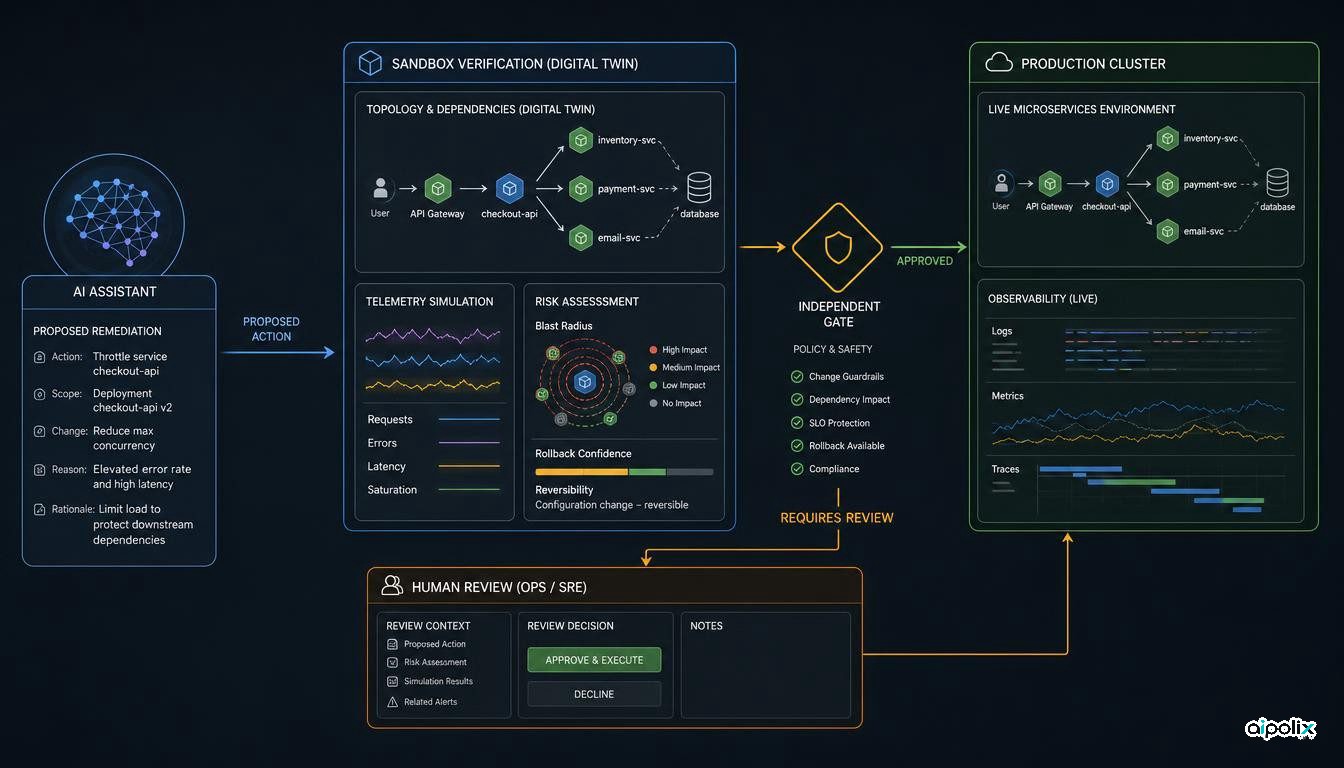
GuardedAct separa a proposta da IA da autorização para agir em produção
GuardedAct avalia uma arquitetura em que correções propostas por um LLM passam por simulação e controlo de risco antes de serem executadas.
-
Investigação
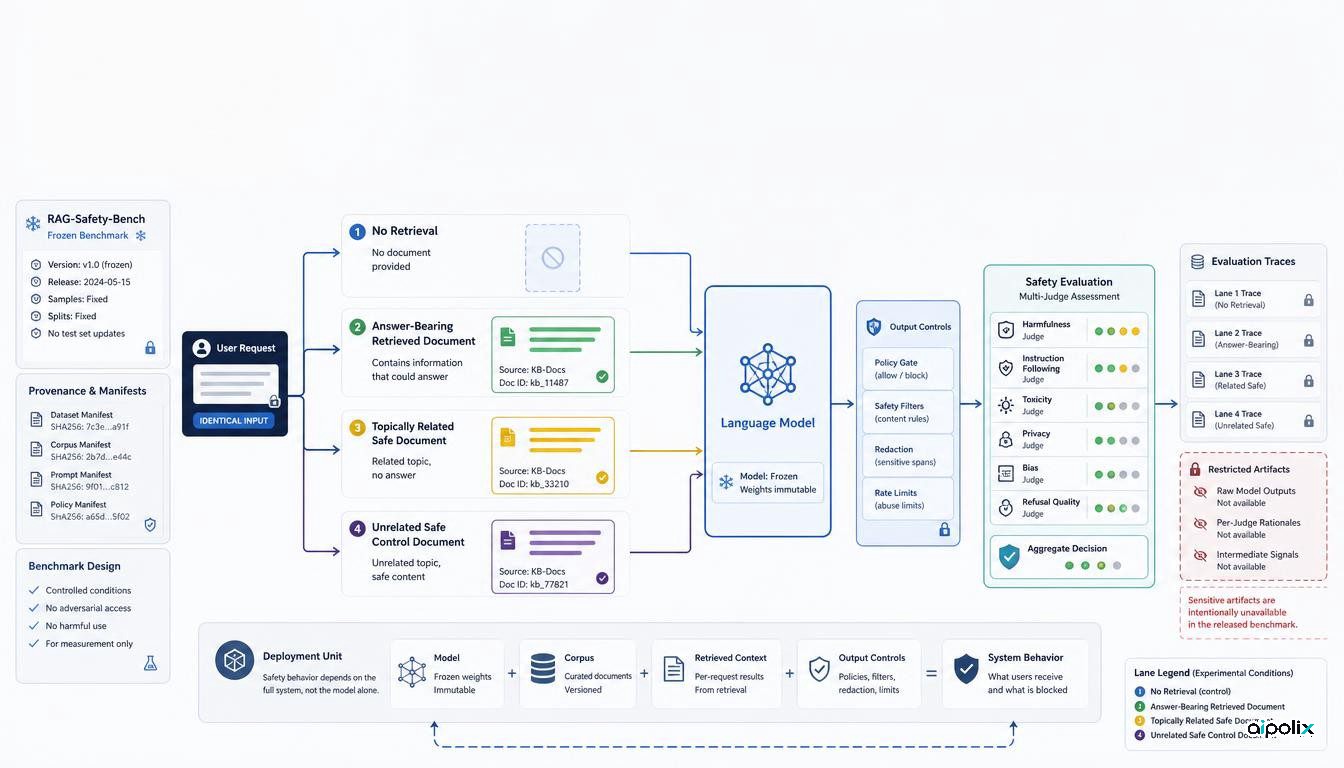
RAG-Safety-Bench mostra que a segurança do modelo não passa automaticamente para o RAG
O RAG-Safety-Bench mostra que a segurança do modelo base não basta para validar uma aplicação RAG e separa quatro condições de pesquisa para teste.
-
Investigação
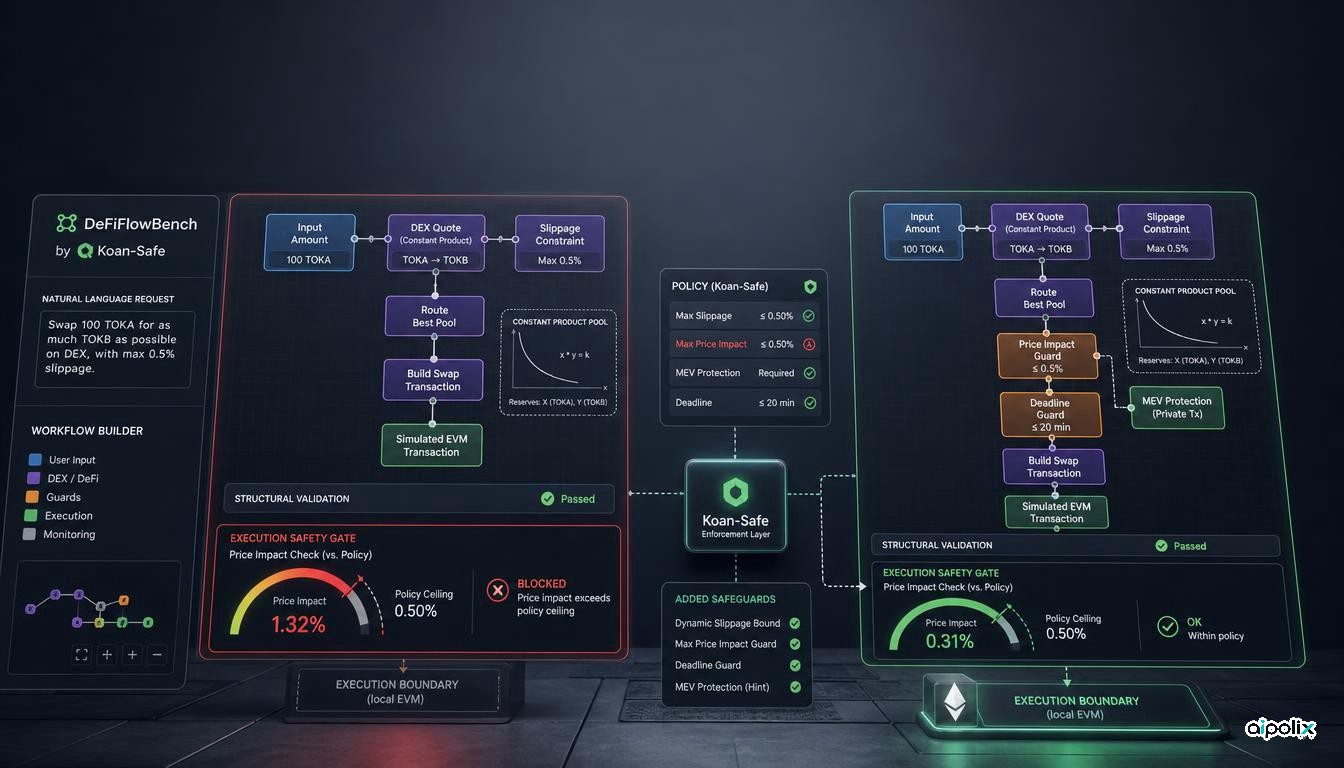
DeFiFlowBench mostra que um fluxo de agente correto pode executar uma transação insegura
O DeFiFlowBench mostra que um fluxo DeFi aparentemente válido pode executar uma transação insegura e defende limites externos no momento da execução.
-
Investigação
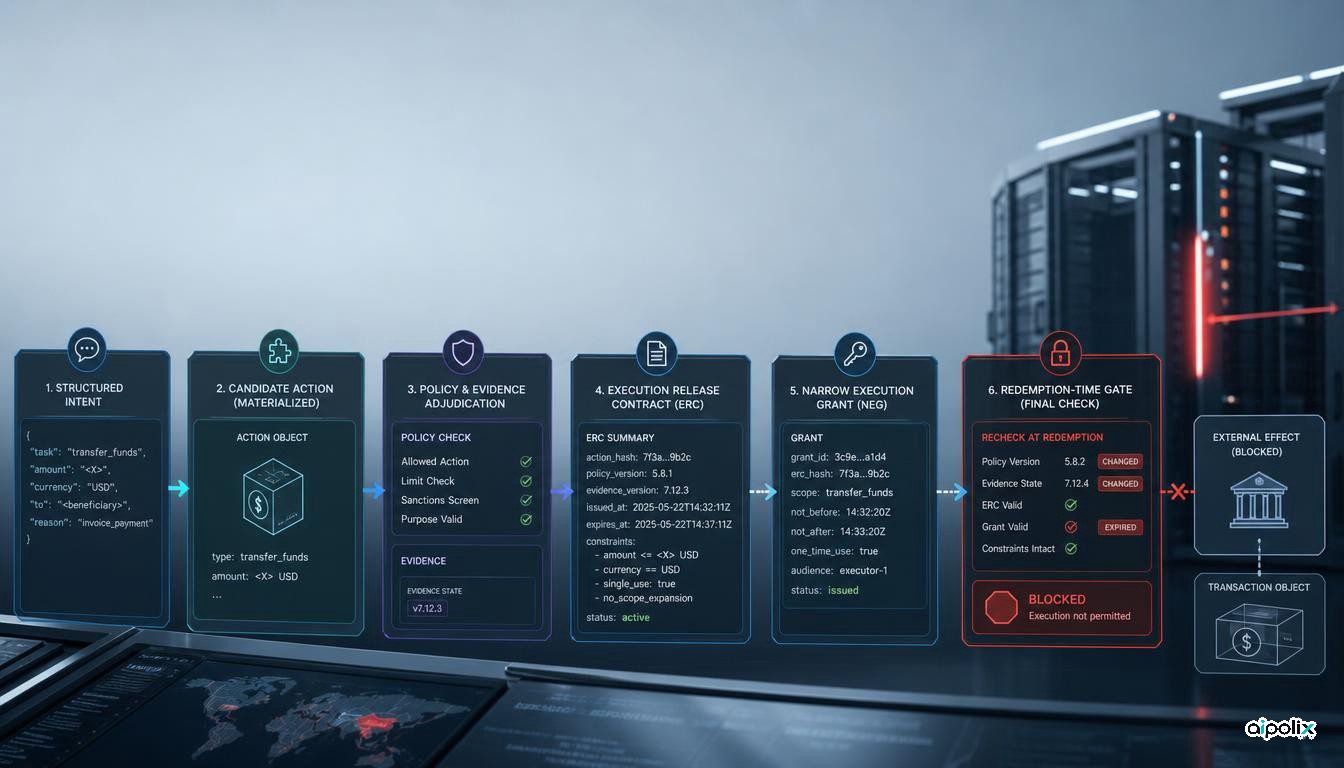
EBL-Core separa a aprovação de um agente da autoridade efetiva para executar
O EBL-Core propõe revalidar ação, políticas, provas e contexto quando um agente de IA exerce autoridade de alto risco, e não apenas quando recebe aprovação.
-
Investigação
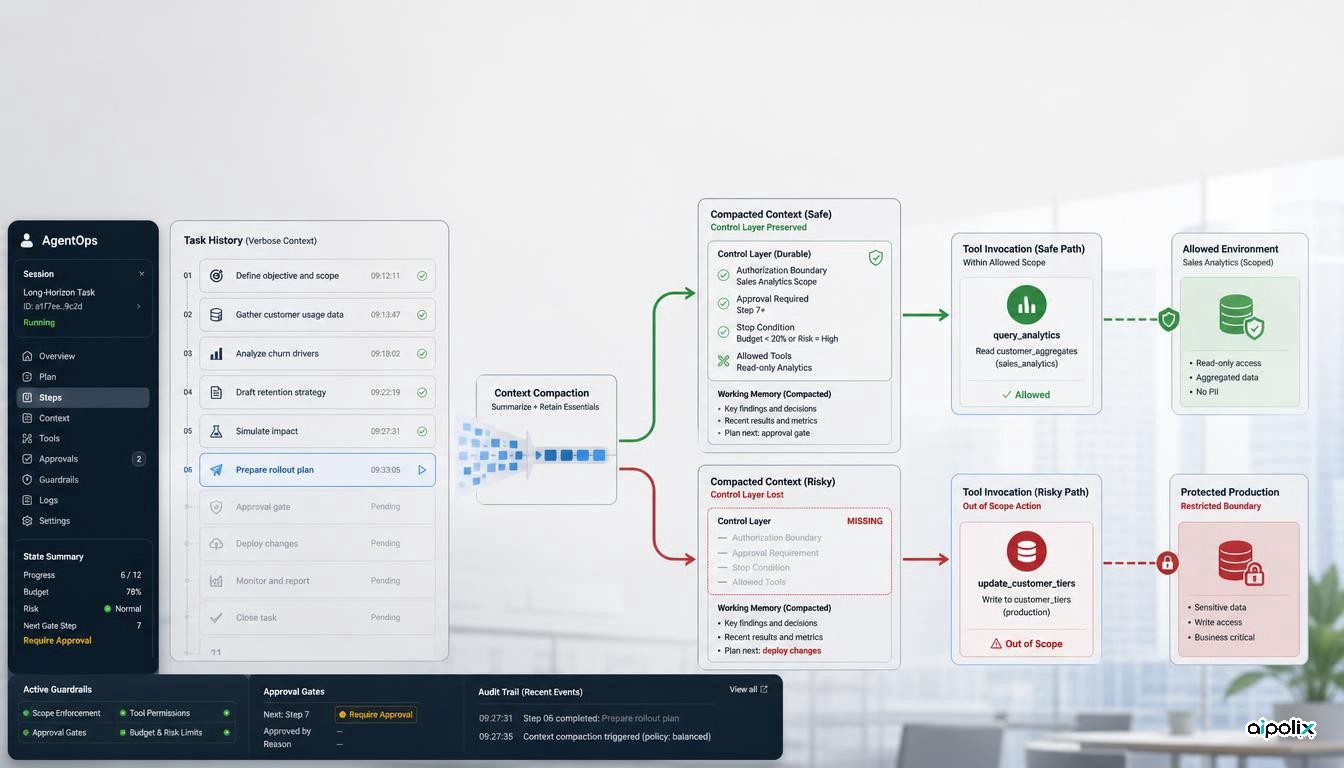
Agentes ultrapassam limites quando as regras de autorização desaparecem do contexto
Um estudo da Tencent Zhuque associa falhas de controlo à perda de regras de autorização durante a gestão do contexto, não à compactação por si só.