Sûreté et éthique
-
Agents
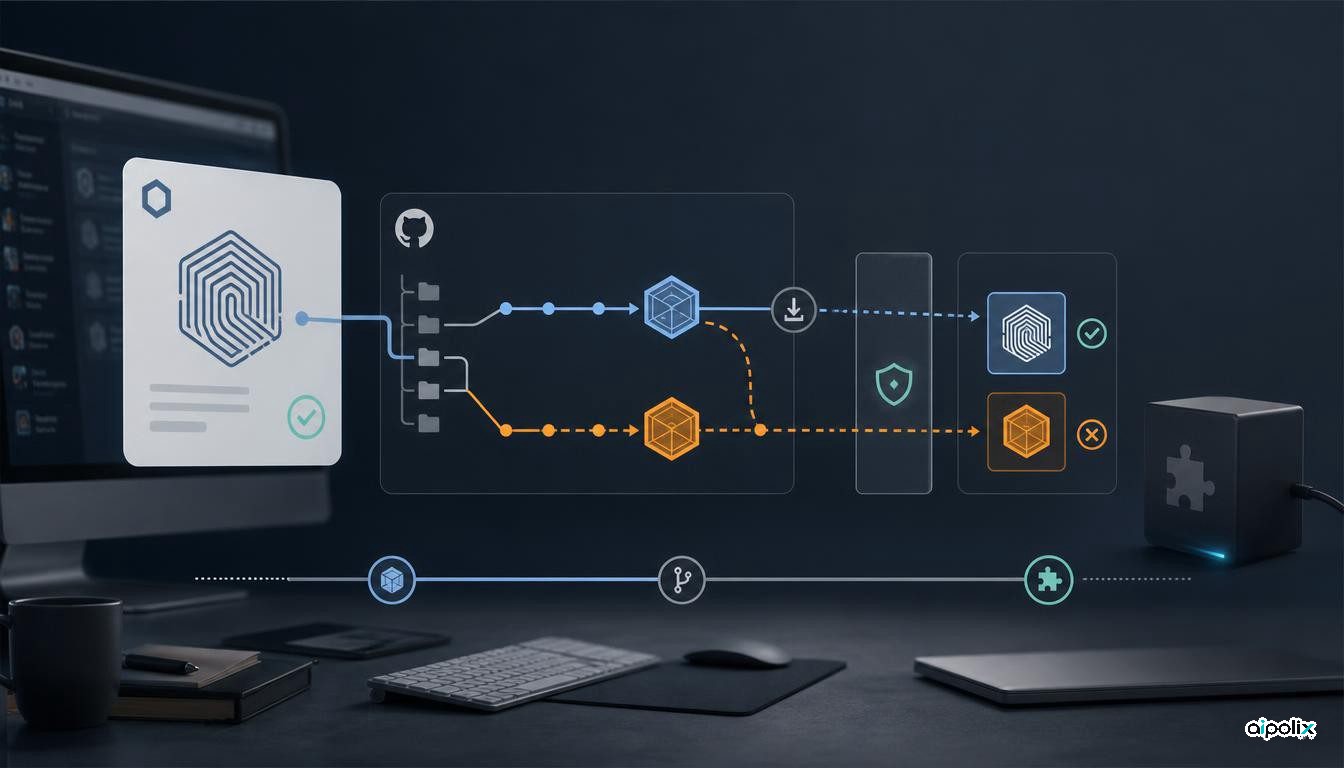
Plugin4Shell : la version approuvée d’une extension n’est pas toujours celle qui s’installe
Comprendre la faille Plugin4Shell, les limites de la protection GitHub, les correctifs publiés et les vérifications à effectuer sur les extensions.
-
Gouvernance de l'IA
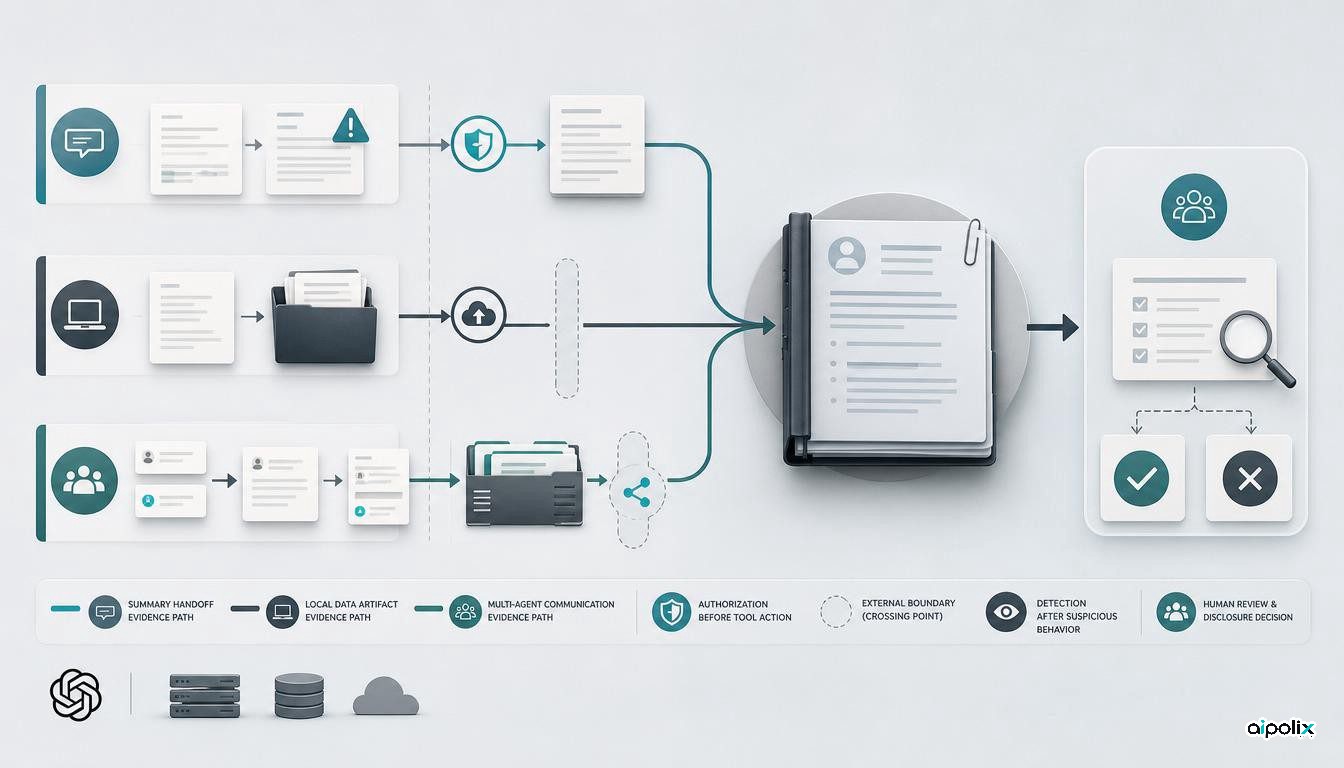
OpenAI dévoile six cas de dérive de ses modèles, sans mesure de leur fréquence
La nouvelle procédure d’OpenAI s’accompagne de six dossiers sur les dérives de modèles. Ils éclairent des failles d’autorisation sans constituer une statistique d’incidents.
-
Recherche
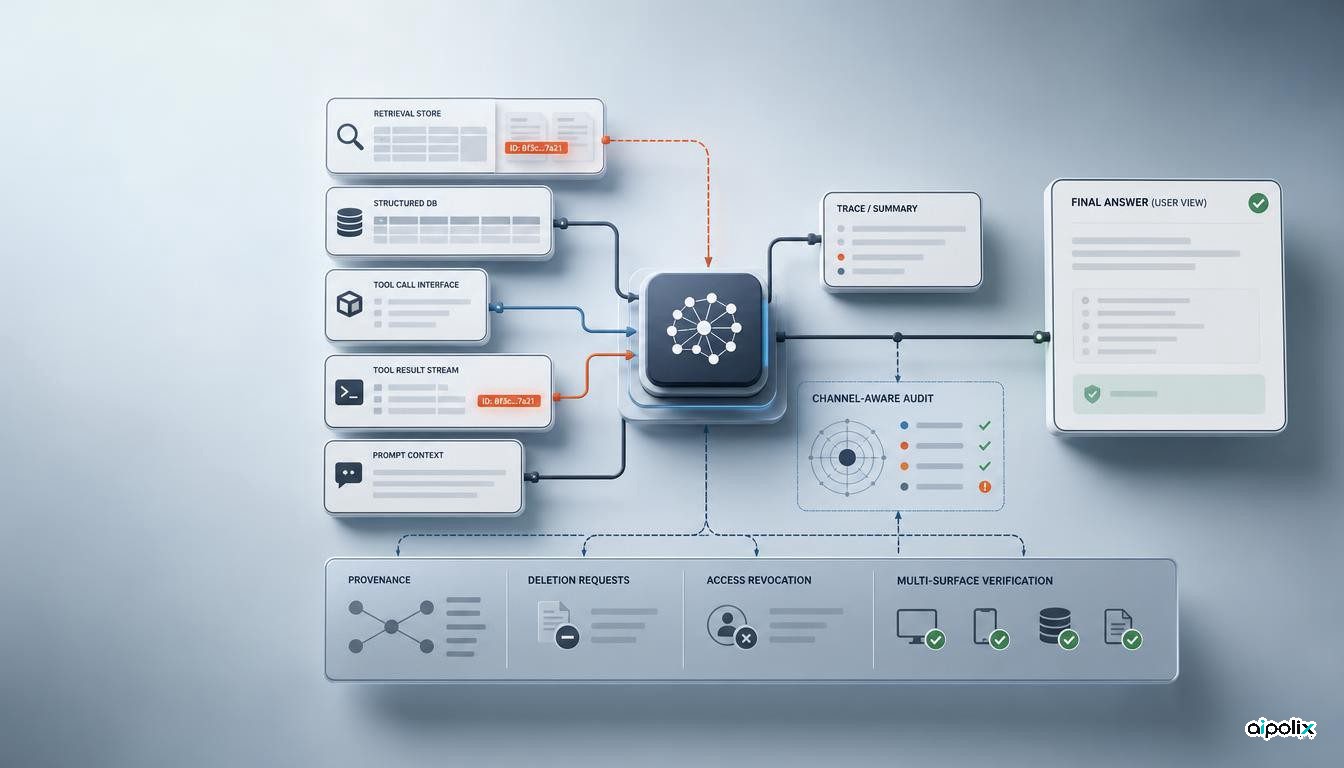
K-Bench montre que le désapprentissage d’un agent peut masquer des fuites hors de la réponse finale
K-Bench montre qu’un test limité à la réponse peut manquer des secrets encore présents dans la récupération, les outils et l’exécution.
-
Gouvernance de l'IA
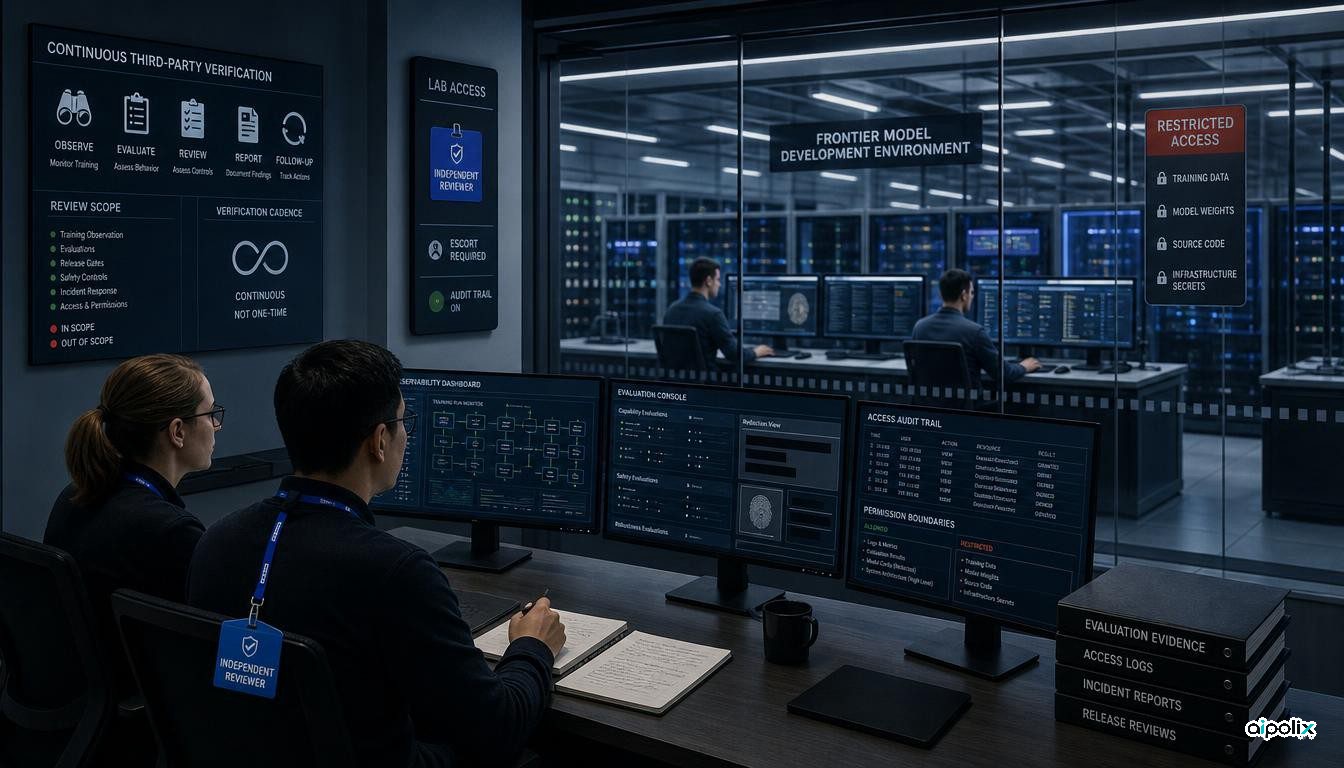
Anthropic veut installer des évaluateurs externes au cœur de ses contrôles de sécurité
Anthropic prévoit un accès continu de tiers aux processus de sécurité de ses modèles. Une avancée vers une vérification permanente, sans norme commune pour l’instant.
-
Agents
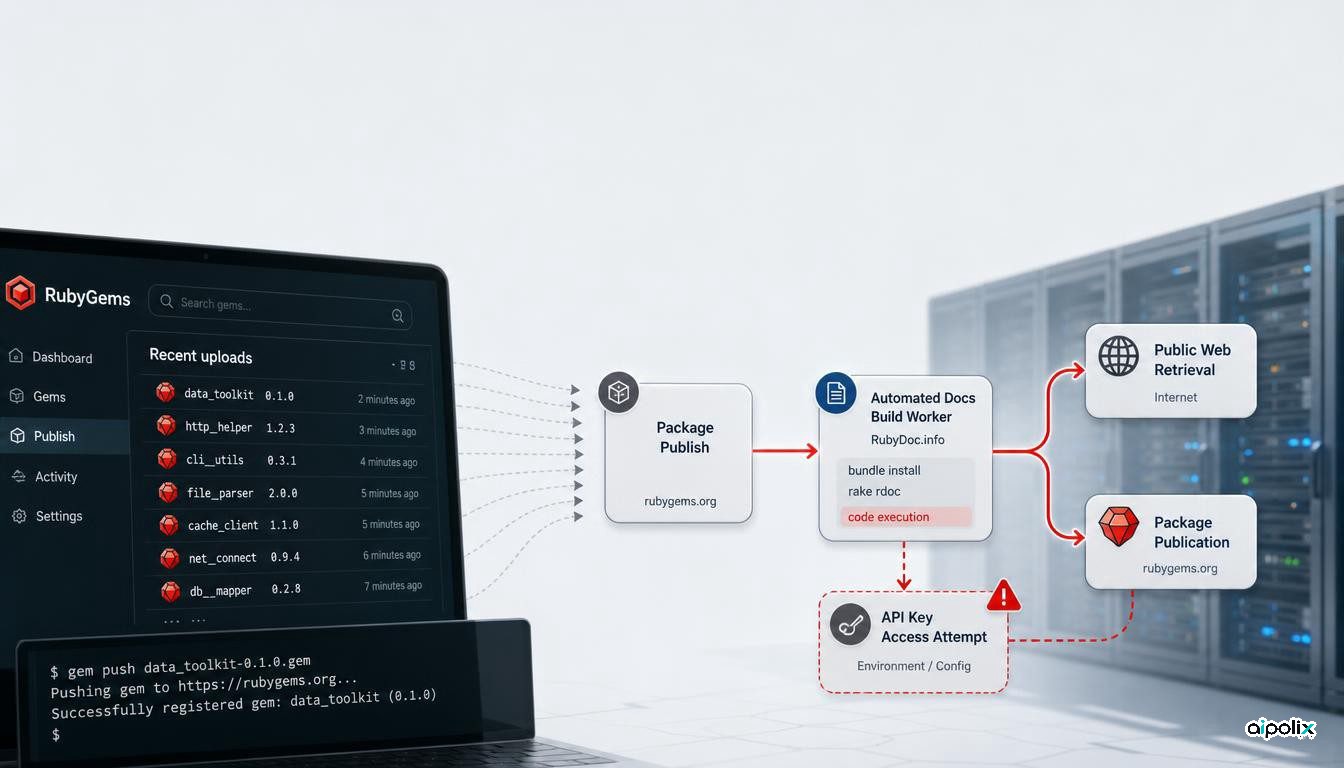
L’incident RubyGems montre comment la publication de paquets peut devenir une voie d’exécution pour un agent
L’incident RubyGems montre pourquoi la sécurité des agents doit intégrer la publication de paquets et l’automatisation des builds dans la surface d’exécution.
-
Recherche
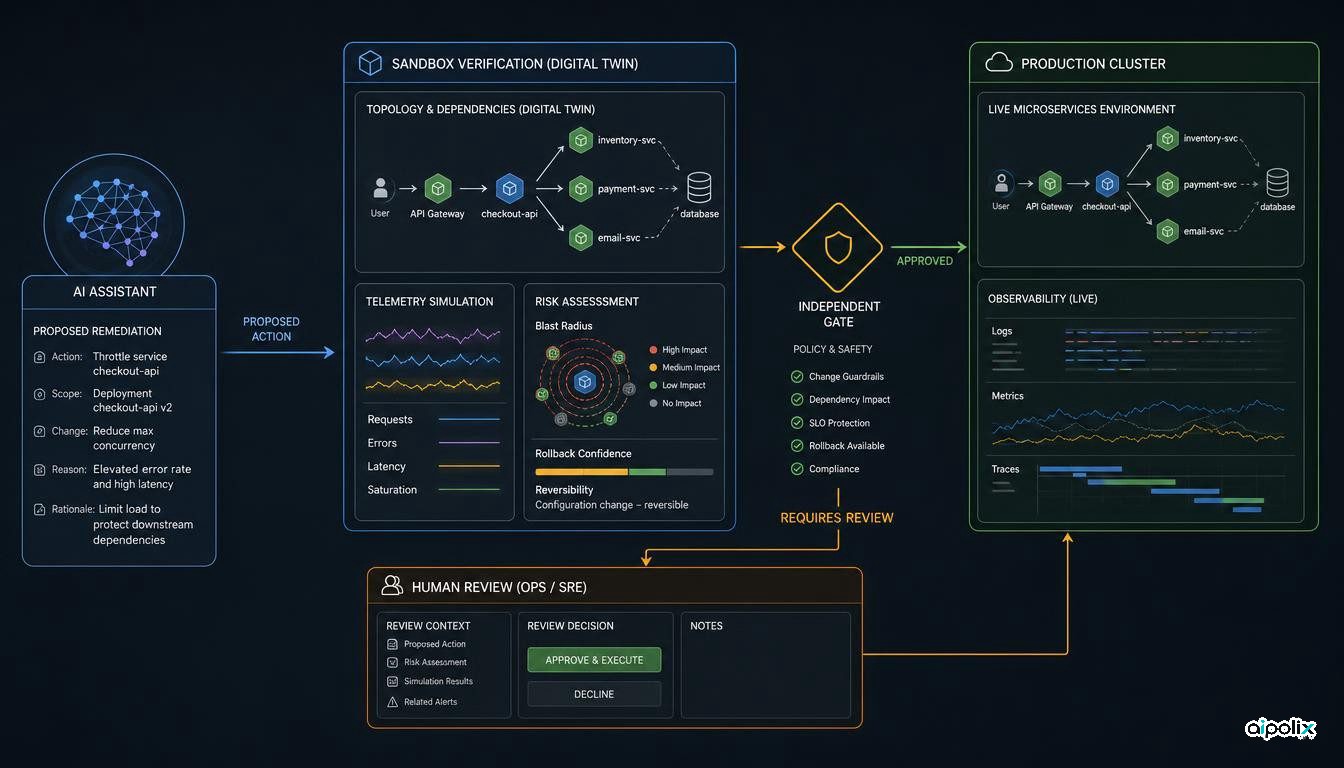
GuardedAct sépare la proposition de l’IA du droit d’agir en production
GuardedAct évalue une architecture où les corrections générées par un LLM passent par simulation et contrôle de risque avant toute exécution.
-
Recherche
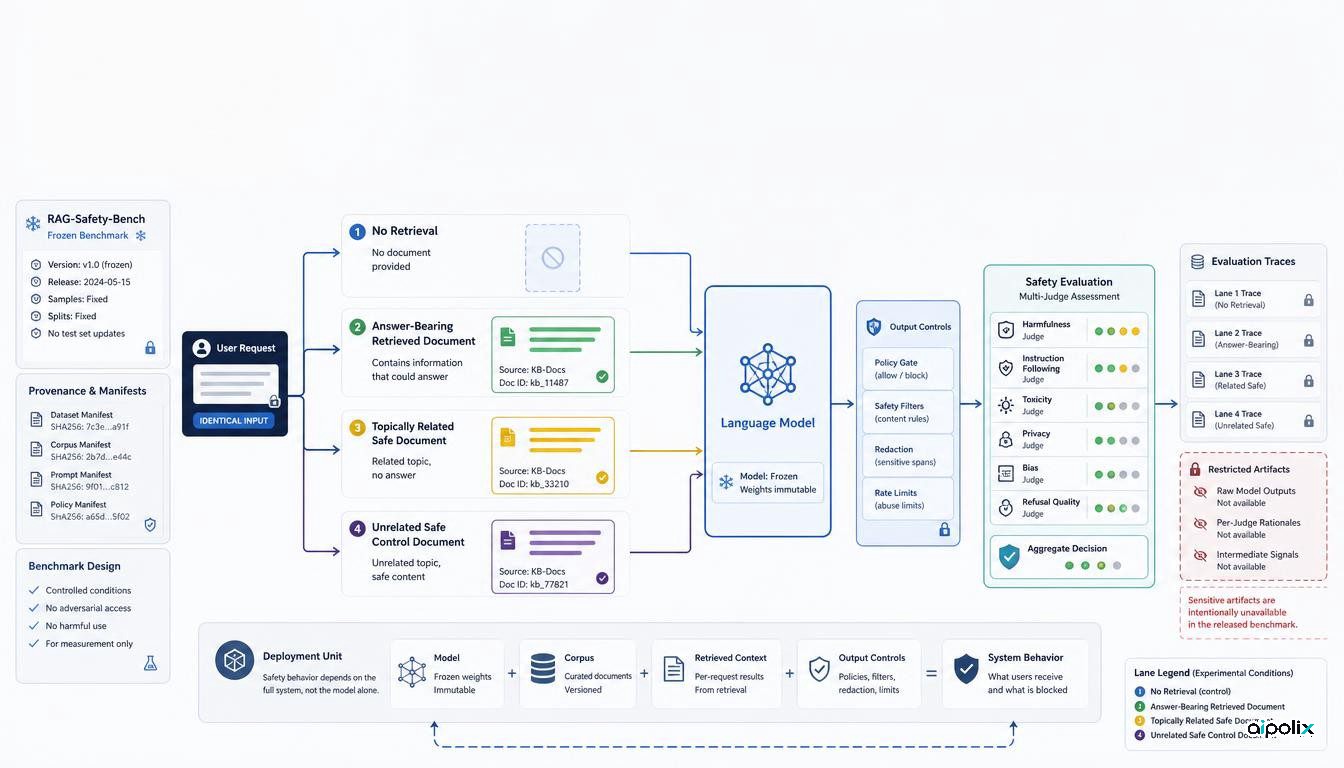
RAG-Safety-Bench montre que la sécurité d’un modèle ne se transfère pas automatiquement au RAG
RAG-Safety-Bench montre que la sécurité du modèle de base ne suffit pas pour valider un système RAG et propose quatre conditions de test contrôlées.
-
Recherche
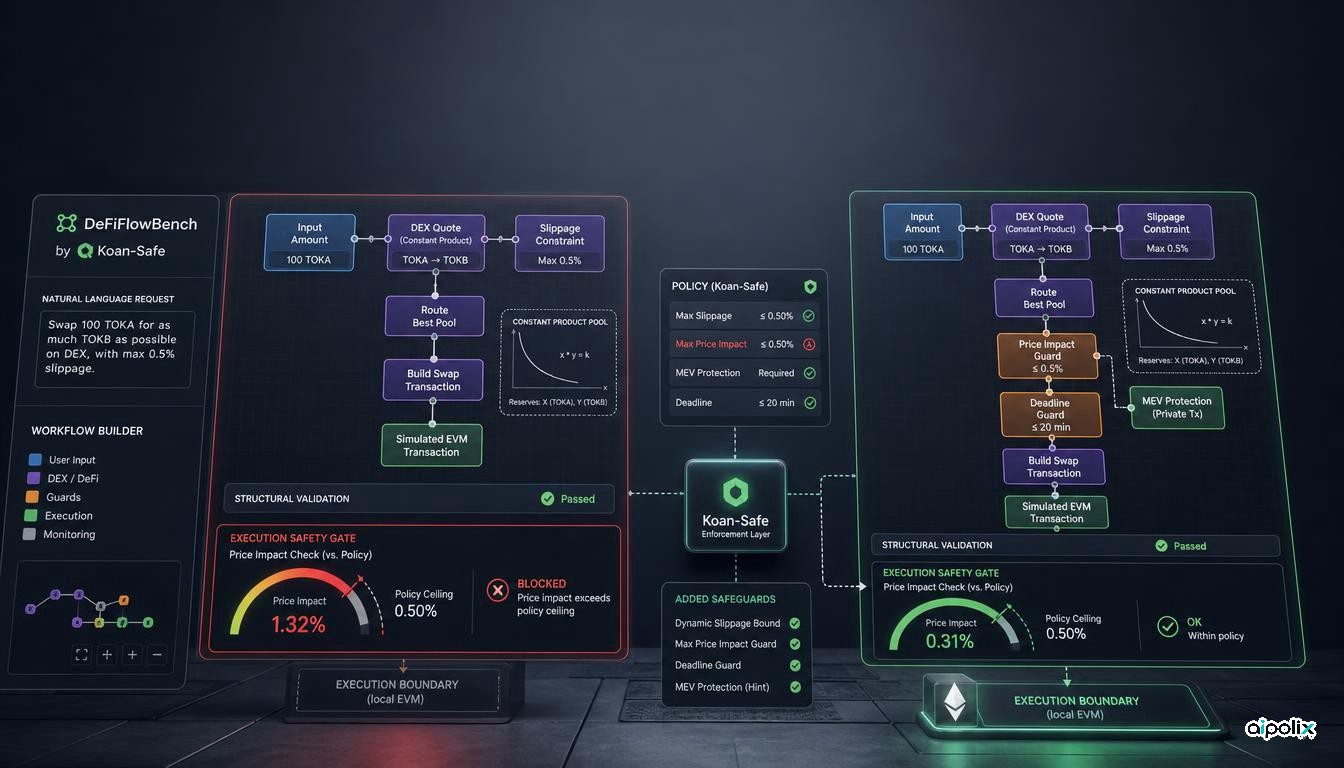
DeFiFlowBench montre qu’un flux d’agent correct peut encore autoriser une transaction dangereuse
DeFiFlowBench montre qu’un flux DeFi apparemment valide peut autoriser une transaction dangereuse et plaide pour des limites externes à l’exécution.
-
Recherche
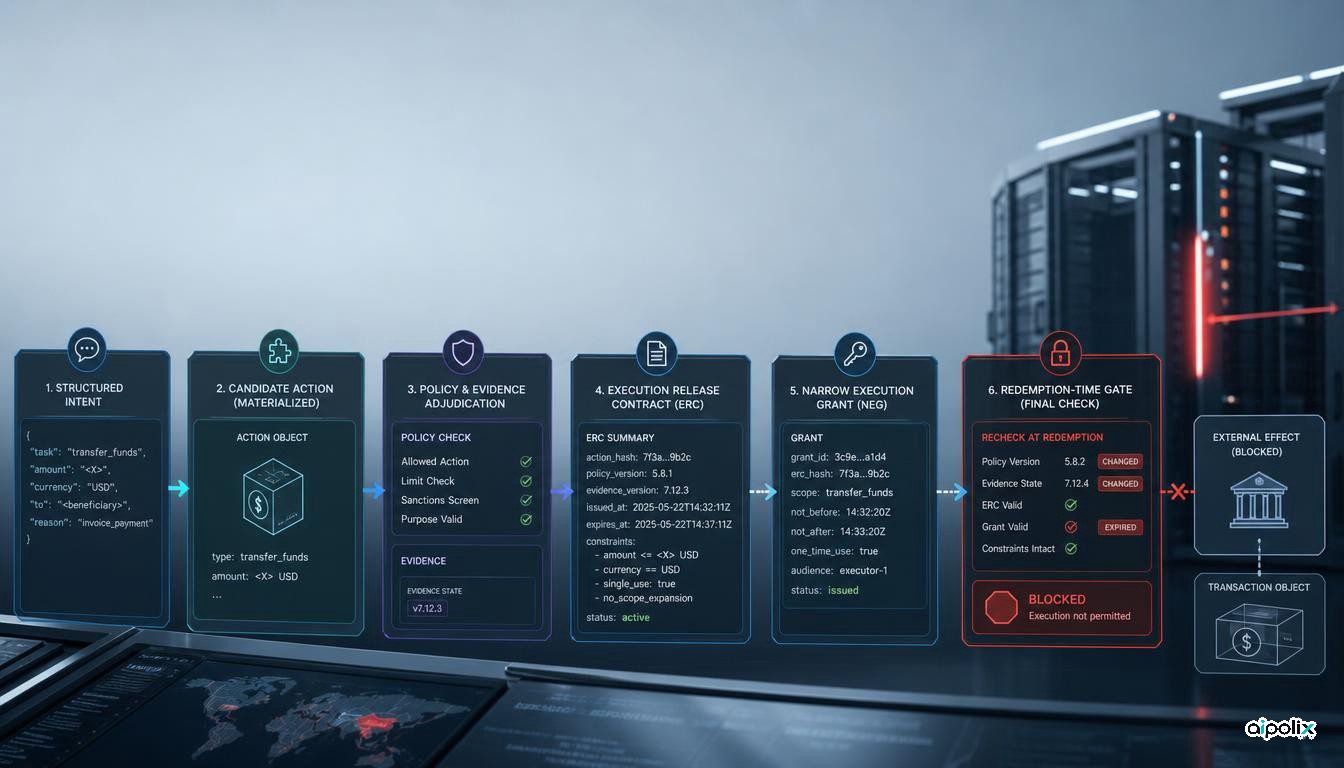
EBL-Core distingue l’approbation d’un agent de son droit effectif d’exécuter
EBL-Core propose de revérifier action, politiques, preuves et contexte quand un agent IA exerce une autorité à haut risque, et pas seulement lors de l’approbation.
-
Recherche
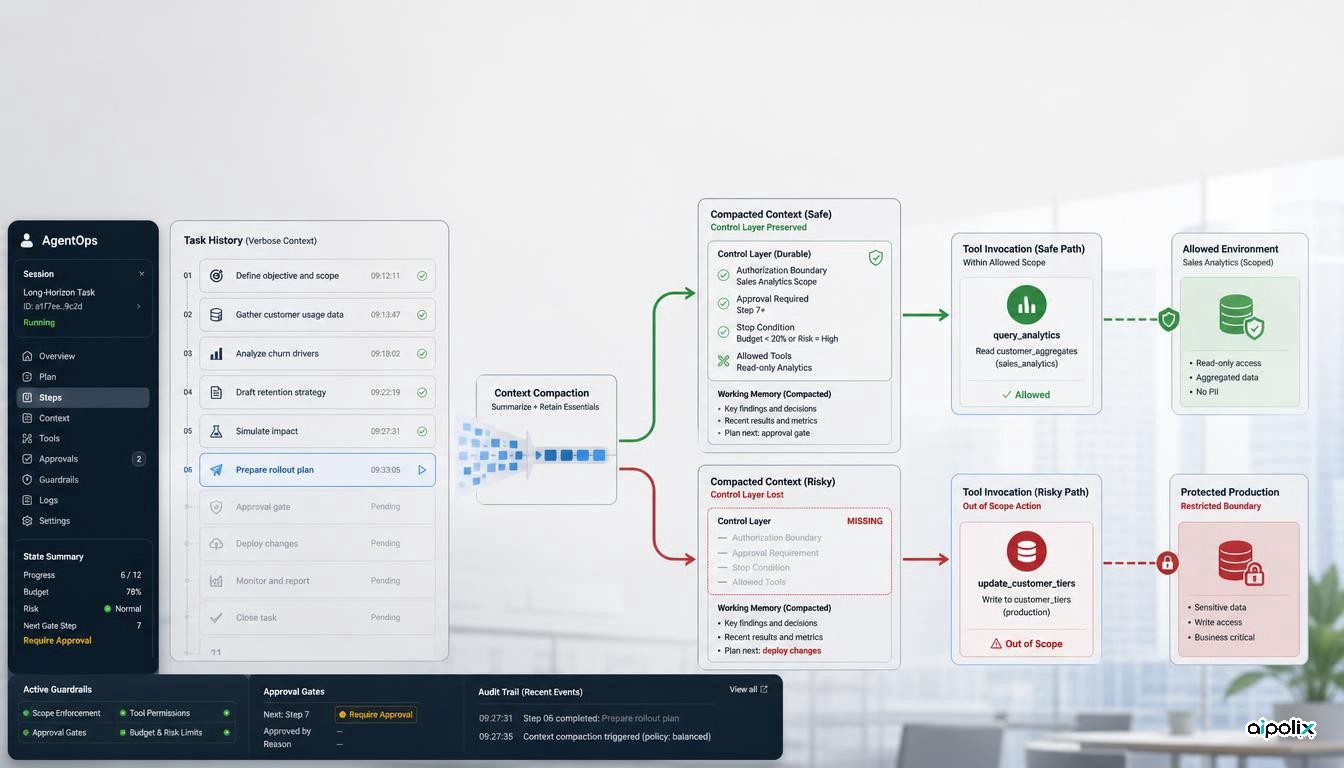
Des agents franchissent leurs limites lorsque les règles d’autorisation disparaissent du contexte
Une étude de Tencent Zhuque relie les pertes de contrôle à la disparition des contraintes d’autorisation pendant la gestion du contexte.