
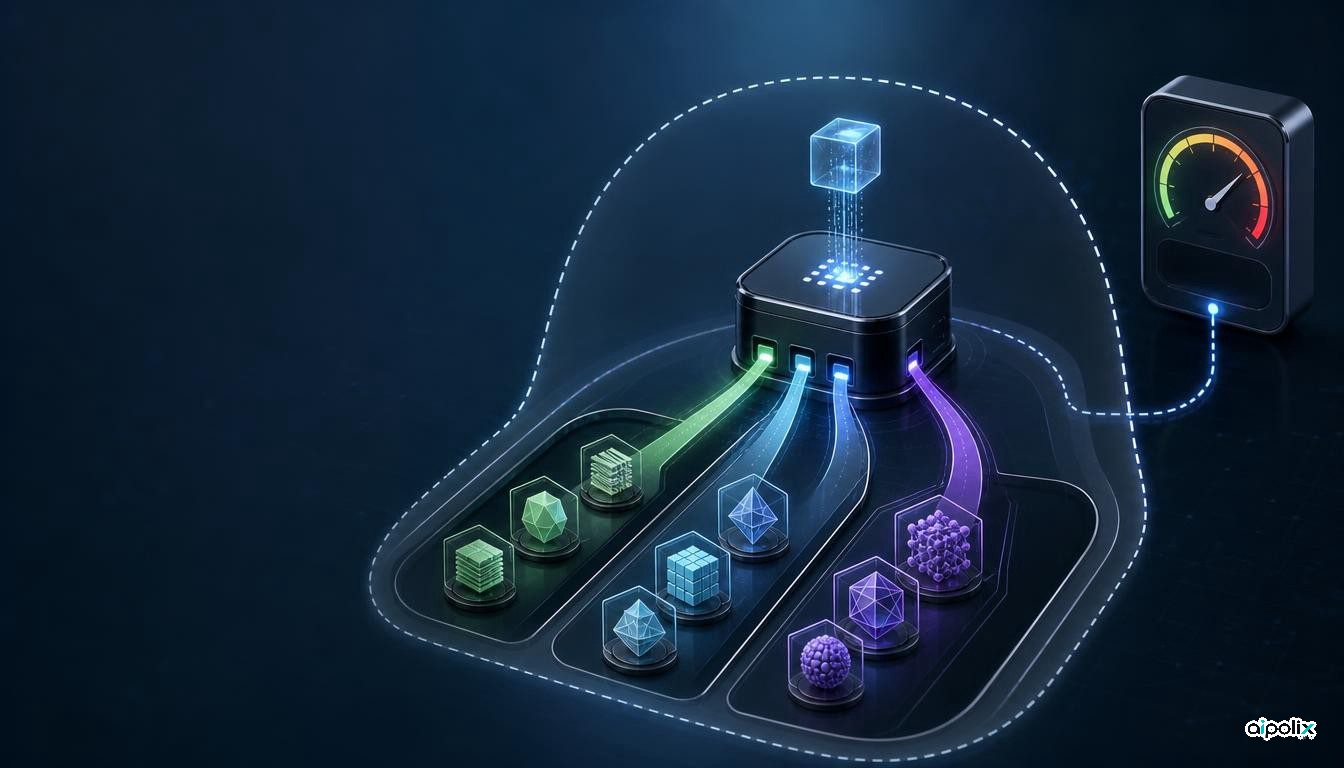
O GitHub acrescentou três níveis de otimização à seleção automática de modelos do Copilot: Efficiency, Balance e Intelligence. A opção indica ao sistema de encaminhamento como deve ponderar custo, tempo de resposta e qualidade esperada em cada pedido, mantendo o mesmo conjunto de modelos que o utilizador e a organização têm autorização para usar.
À primeira vista é uma simples preferência. Na prática, mostra uma mudança importante nos produtos de programação com vários modelos: a escolha do modelo passa a ser uma política executada em tempo real para cada tarefa, em vez de uma decisão fixa do programador.
Existe, porém, uma limitação essencial. Escolher Efficiency não cria um teto de despesa e Intelligence não obriga todas as tarefas a usar o modelo mais caro. O GitHub afirma que a faturação continua a depender do modelo que Auto selecionar efetivamente.
O encaminhamento passa a ter um objetivo explícito
O Copilot Auto já escolhia modelos de forma dinâmica. Segundo a documentação do GitHub, a otimização por tarefa combina a complexidade do trabalho com o estado e disponibilidade dos modelos, procurando reservar modelos de raciocínio mais caros para problemas que realmente os justificam.
Os três níveis acrescentam uma preferência definida pelo utilizador.
Efficiency dá prioridade a custos mais baixos e tarefas rápidas. Balance pondera custo, qualidade e latência em conjunto. Intelligence privilegia a qualidade em problemas mais complexos. Os três níveis usam, contudo, o mesmo conjunto de modelos disponíveis e cada pedido é avaliado individualmente.
Este último ponto é importante. Mesmo em Intelligence, o GitHub diz que um pedido simples, como adicionar uma docstring a uma função, pode ser encaminhado para um modelo pequeno. O nível altera a função de otimização; não é uma correspondência fixa entre uma opção e um determinado modelo.
Preferir custos baixos não é impor um orçamento
O nome Efficiency pode levar a uma interpretação demasiado forte.
O GitHub esclarece que a utilização é cobrada de acordo com o modelo escolhido por Auto, independentemente do nível. Os subscritores pagos continuam a receber um desconto de 10% no uso através de Auto, mas o custo final continua dependente do encaminhamento e dos tokens consumidos.
A análise da Aipolix é que Efficiency deve ser tratado como uma preferência de otimização, não como um controlo financeiro determinístico.
Uma organização que precise de um limite rígido de despesa continua a necessitar de controlos de orçamento, monitorização de consumo ou restrições sobre os modelos permitidos. Um sistema probabilístico que tenta escolher alternativas mais económicas pode reduzir o custo médio, mas não substitui uma barreira imposta fora do algoritmo.
O mesmo se aplica a Intelligence. A opção favorece qualidade, mas não garante um modelo de topo em todos os pedidos nem um determinado resultado de avaliação comparativa.
As políticas da organização continuam a definir a fronteira
A documentação do GitHub afirma que Auto apenas escolhe entre modelos permitidos pelo plano e pelas políticas da organização. Modelos bloqueados por administradores, incompatíveis com requisitos de residência de dados ou excluídos por restrições FedRAMP não entram no conjunto de escolha.
Esta separação é importante.
A organização decide primeiro quais os modelos autorizados. O sistema de encaminhamento otimiza depois dentro desse conjunto. Assim, um utilizador pode selecionar Intelligence sem contornar silenciosamente uma proibição aplicada a um fornecedor ou modelo.
À medida que estes sistemas de encaminhamento se tornam mais autónomos, a distinção ganha importância. Otimizar custo e qualidade deve acontecer dentro da política de autorização, não definir essa política.
Porque interessa aos agentes de programação
Os agentes de programação executam cada vez mais sessões longas com várias etapas: exploram o repositório, escrevem código, executam testes, corrigem erros e ajudam na revisão. Nem todas essas fases precisam do mesmo modelo.
Uma camada de encaminhamento pode entregar trabalho simples a modelos menores e reservar raciocínio mais dispendioso para etapas difíceis. O GitHub também explica que a otimização por tarefa procura mudar de modelo em fronteiras naturais da cache, porque trocar a meio de uma sessão pode aumentar os custos associados à cache sem produzir um ganho suficiente de qualidade.
Os três níveis tornam mais visível o objetivo desta orquestração.
Ao mesmo tempo, criam uma necessidade de observabilidade. Para comparar Efficiency, Balance e Intelligence, uma equipa deve medir não apenas a fatura total, mas também quais os modelos escolhidos, a latência, a conclusão real das tarefas, as repetições e o esforço de revisão humana. O GitHub já mostra o modelo usado em cada resposta em várias superfícies do Copilot, fornecendo parte dessa informação.
O que ainda não sabemos
Os níveis estão a ser disponibilizados no Visual Studio Code, Copilot CLI e na aplicação GitHub Copilot. O GitHub descreve esta alteração como um primeiro passo para tornar a seleção de modelos mais configurável.
A empresa não publicou um avaliação comparativa que mostre quanto cada nível altera custo, latência ou qualidade de programação. Também não existe uma regra determinística pública para prever que modelo será usado em cada pedido. Por isso, não é possível transformar os nomes das opções em percentagens concretas de poupança ou de melhoria.
A relevância técnica está noutro ponto: um produto de programação com vários modelos passou a expor a intenção do encaminhamento como um controlo de primeira classe, mantendo separados a faturação e os limites impostos pelas políticas empresariais.
A distinção é útil e deve ser preservada: «preferir mais barato» não significa «nunca gastar acima deste valor», tal como «privilegiar inteligência» não significa «usar sempre o modelo mais poderoso».