
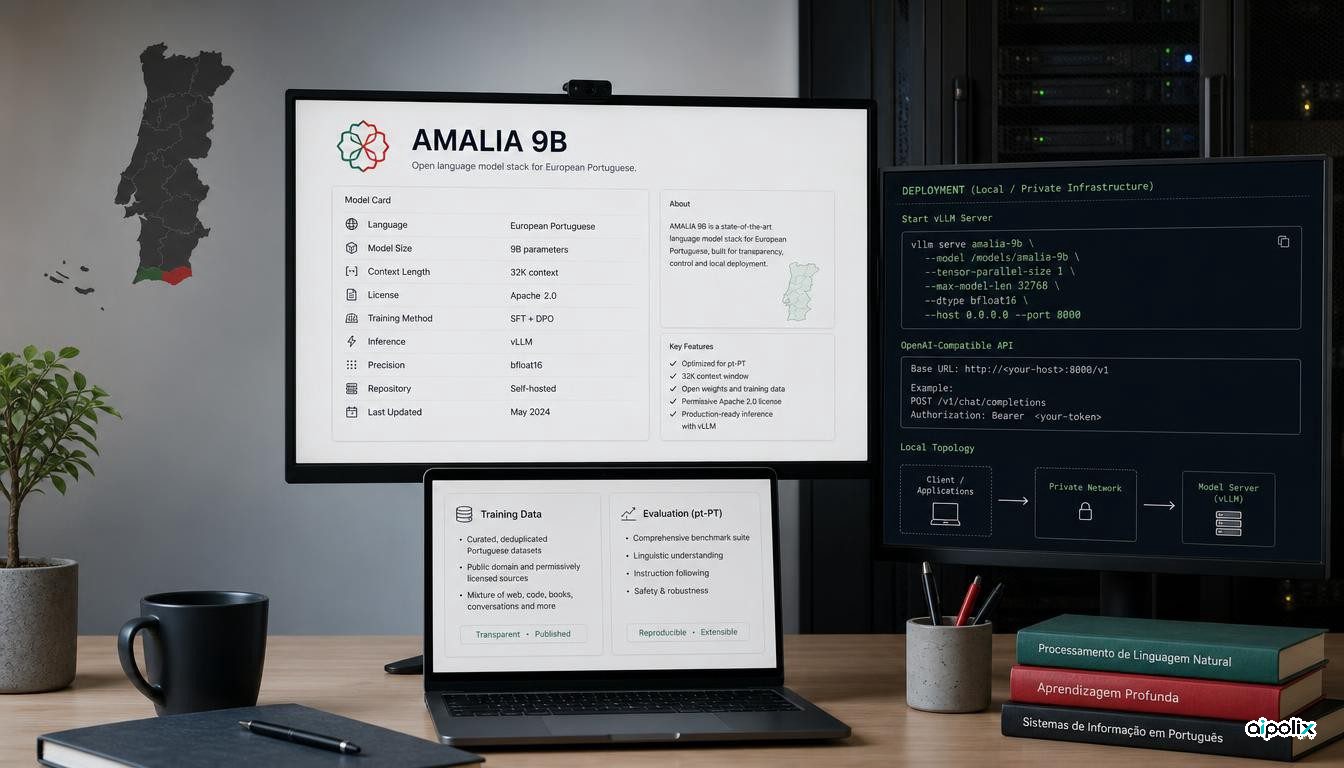
Le projet portugais AMALIA a publié un modèle de langage installable de 9 milliards de paramètres, conçu spécifiquement autour du portugais européen, avec ses jeux de données d’entraînement, ses ressources d’évaluation et un parcours public d’installation. La version finale d’AMALIA est devenue publiquement disponible le 1 July 2026, et l’instantané actuel 0626 DPO est distribué sous Apache 2.0 par l’organisation du projet sur Hugging Face.
L’enjeu technique ne se réduit pas à doter le Portugal d’un énième dialogueur en langue nationale. AMALIA prolonge le pré-entraînement d’EuroLLM avec davantage de données de portugais européen, porte la longueur maximale de séquence à 32,000 jetons, puis applique un affinage supervisé et le Direct Preference Optimization. Le projet publie aussi les jeux SFT et DPO ainsi qu’une batterie d’évaluation orientée pt-PT, ce qui rend la publication plus inspectable qu’un modèle accessible uniquement derrière une interface hébergée.
Un modèle 9B ajusté au portugais européen
D’après la fiche officielle du modèle AMALIA, le projet utilise des données d’Arquivo.pt, des données de pré-entraînement EuroLLM, des échantillons de longue séquence de Stack-v2 et des exemples synthétiques de longue séquence. L’étape postérieure à l’entraînement combine l’affinage supervisé et l’ajustement par préférences via DPO.
L’étape SFT a duré 76 hours sur 64 GPU NVIDIA H100, et l’étape DPO 12 hours supplémentaires sur le même nombre de GPU. L’entraînement a utilisé le supercalculateur MareNostrum 5 au Barcelona Supercomputing Center et le système DEUCALION au Minho Advanced Computing Center.
Cela compte pour les développeurs portugais parce que le modèle est présenté comme une base réutilisable, et non seulement comme une démonstration publique. Le projet publie l’instantané, les données et les outils d’évaluation sous licences ouvertes, afin que les équipes puissent les inspecter, les réajuster et les mettre à disposition dans leur propre infrastructure.
L’évaluation native pt-PT fait partie de la publication
Le rapport technique AMALIA soutient que le portugais européen est sous-représenté non seulement dans les corpus d’entraînement, mais aussi dans l’évaluation. Les épreuves traduites automatiquement peuvent manquer le vocabulaire, la grammaire et les distinctions culturelles entre portugais européen et brésilien.
Pour y répondre, le projet a publié des épreuves pt-PT qui mêlent des tâches standard traduites et de nouveaux jeux de données axés sur la génération en portugais européen, la compétence linguistique et le biais pt-PT versus pt-BR. Les auteurs indiquent qu’AMALIA reste compétitif face à de solides références sur les épreuves traduites, tout en s’améliorant sur les évaluations conçues spécifiquement pour le portugais européen.
Ces résultats doivent se lire comme des constatations de recherche rapportées par le projet, et non comme une preuve indépendante qu’AMALIA serait généralement supérieur aux modèles commerciaux de premier plan. Le signal d’ingénierie est plus étroit : l’équipe a créé une surface d’évaluation explicitement conçue pour détecter un comportement pt-PT que les épreuves multilingues génériques peuvent négliger.
Les développeurs peuvent le mettre à disposition via un point d’accès de type OpenAI
Le guide de démarrage GitHub recommande vLLM pour mettre à disposition l’instantané 0626 DPO. Une commande vLLM standard expose le modèle en local et le rend accessible via une API de complétion de dialogue compatible avec OpenAI.
Cela facilite l’insertion d’AMALIA dans des architectures d’application existantes. Une équipe peut l’exécuter comme service d’inférence local ou privé, conserver les données dans une infrastructure qu’elle contrôle, et orienter certaines charges de travail portugaises vers AMALIA sans reconstruire toute la couche cliente.
L’échelle 9B a aussi une portée opérationnelle. Le modèle est beaucoup plus petit que les systèmes de premier plan et a déjà attiré des quantifications communautaires pour llama.cpp et Apple Silicon, même si ces constructions dérivées sont des artefacts communautaires distincts, et non la publication officielle.
Le Portugal traite le modèle comme une infrastructure souveraine d’IA
L’annonce de Digital.gov.pt présente AMALIA comme le premier grand modèle de langage conçu spécifiquement pour le portugais européen et le cadre culturel national. La publication de juillet comprend aussi une branche multimodale, mais l’ensemble textuel est déjà utile indépendamment pour les développeurs, parce que les poids, les jeux de données et le parcours de mise à disposition sont disponibles dès maintenant.
L’argument d’IA souveraine ne doit pas se réduire à la nationalité du modèle. La valeur plus concrète est le contrôle de l’ensemble technique complet : poids du modèle, divulgation des données d’entraînement, ressources d’évaluation et choix d’installation. Cela peut compter pour les systèmes du secteur public, les charges de travail réglementées, les produits propres à une langue et la recherche où la dépendance à une API propriétaire distante est indésirable.
AMALIA ne dispense pas d’un examen de sécurité, d’une évaluation de domaine ou d’une comparaison avec des modèles plus grands. La fiche du modèle recommande explicitement une validation des entrées et un filtrage des sorties adaptés à chaque installation, et la date de coupure des connaissances est June 2024. Les équipes doivent mesurer leurs propres tâches avant de supposer que la spécialisation native pt-PT l’emporte sur des écarts de raisonnement général, d’usage des outils ou de fraîcheur.
Pour les lecteurs d’Aipolix, cette publication se comprend donc surtout comme une nouvelle pièce d’infrastructure portugaise d’IA : non pas la prétention qu’un modèle 9B remplace les systèmes mondiaux de premier plan, mais un modèle ouvert pleinement installable, qui offre au portugais européen une voie native plus solide pour l’inférence locale, l’adaptation et l’évaluation.