
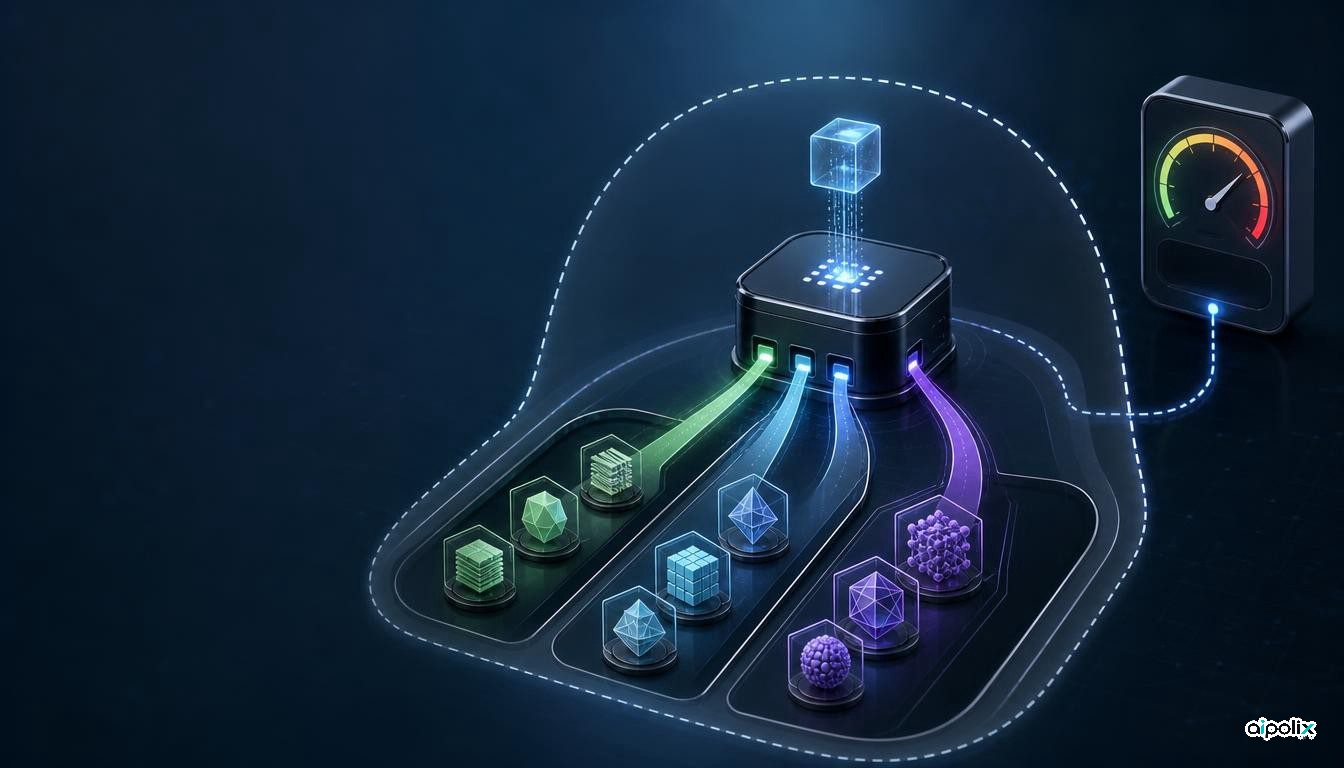
GitHub ajoute trois niveaux d’optimisation à la sélection automatique des modèles de Copilot : Efficiency, Balance et Intelligence. Le réglage indique au routeur comment arbitrer le coût, le temps de réponse et la qualité attendue pour chaque requête, sans modifier l’ensemble des modèles autorisés pour l’utilisateur.
Derrière ce qui ressemble à une préférence d’interface se trouve une évolution plus importante : dans les outils de programmation multi-modèles, le choix du modèle devient une politique d’exécution appliquée au moment de la requête, et non plus nécessairement une décision prise une fois par le développeur.
Il existe toutefois une limite essentielle. Efficiency ne constitue pas un plafond de dépense et Intelligence ne force pas chaque requête vers le modèle le plus coûteux. La facturation dépend toujours du modèle effectivement choisi par Auto.
Le routeur reçoit désormais un objectif explicite
Copilot Auto sélectionnait déjà les modèles de manière dynamique. La documentation de GitHub indique que l’optimisation par tâche combine la complexité de la demande avec l’état et la disponibilité des modèles, afin de réserver les modèles de raisonnement plus coûteux aux problèmes qui en ont réellement besoin.
Les trois niveaux ajoutent un objectif choisi par l’utilisateur à ce mécanisme.
Efficiency privilégie les coûts faibles et les tâches simples. Balance arbitre entre coût, qualité et latence. Intelligence privilégie la qualité pour les tâches complexes. Les trois utilisent néanmoins le même ensemble de modèles, et Auto évalue chaque requête séparément.
Ce point est important : même avec Intelligence, GitHub explique qu’une demande élémentaire, comme ajouter une docstring à une fonction existante, peut être envoyée vers un petit modèle. Le niveau modifie donc la fonction d’optimisation du routeur ; il ne correspond pas à un modèle fixe.
Une préférence économique n’est pas une limite budgétaire
Le nom Efficiency peut induire les équipes en erreur.
GitHub précise que l’usage est facturé selon le modèle sélectionné par Auto, quel que soit le niveau choisi. Les abonnés payants conservent une remise de 10 % sur l’usage facturé via Auto, mais le coût final dépend toujours du routage et de la consommation réelle.
L’analyse d’Aipolix est qu’Efficiency doit être considéré comme une préférence d’optimisation, et non comme un garde-fou financier déterministe.
Une organisation qui a besoin d’un plafond strict doit toujours appliquer des contrôles budgétaires, surveiller la consommation ou limiter les modèles autorisés. Un routeur qui favorise statistiquement les modèles moins chers peut réduire le coût moyen, mais il ne remplace pas une limite imposée en dehors de l’algorithme.
La même nuance vaut pour Intelligence. Le mode privilégie la qualité ; il ne promet pas qu’un modèle de pointe sera utilisé à chaque tour ni qu’un score de évaluation comparative particulier sera atteint.
Les politiques d’entreprise restent prioritaires
La documentation précise qu’Auto ne sélectionne que des modèles permis par l’abonnement et les politiques de l’organisation. Les modèles bloqués par un administrateur, incompatibles avec une exigence de résidence des données ou exclus pour des raisons FedRAMP ne font pas partie du choix possible.
Cette séparation est saine.
L’organisation définit d’abord l’enveloppe des modèles autorisés. Le routeur optimise ensuite à l’intérieur de cette enveloppe. Un utilisateur peut donc sélectionner Intelligence sans contourner silencieusement une interdiction portant sur un fournisseur ou un modèle.
Plus les routeurs deviennent autonomes, plus cette distinction compte. L’optimisation du coût et de la qualité doit rester subordonnée aux règles d’autorisation.
Un enjeu particulier pour les agents de programmation
Les agents de programmation ne se limitent plus à un échange isolé. Une même session peut comprendre l’exploration d’un dépôt, la génération de code, des tests, du débogage et une phase de revue. Toutes ces étapes ne nécessitent pas la même puissance de modèle.
Un routeur peut confier les opérations simples à des modèles plus petits et réserver un raisonnement plus coûteux aux étapes difficiles. GitHub indique également que son routage optimisé par tâche évite autant que possible les changements de modèle en dehors de frontières naturelles de cache, car basculer au mauvais moment peut augmenter les coûts sans gain suffisant de qualité.
Les nouveaux niveaux rendent l’objectif de cette orchestration plus visible.
Ils créent aussi un besoin d’observabilité. Pour comparer Efficiency, Balance et Intelligence, une équipe doit suivre le coût, les modèles réellement sélectionnés, la latence, le taux d’achèvement des tâches, les nouvelles tentatives et le volume de revue humaine. GitHub affiche déjà le modèle utilisé pour chaque réponse dans plusieurs interfaces Copilot, ce qui fournit une partie de ces données.
Ce que GitHub ne démontre pas encore
Les trois niveaux sont en cours de déploiement dans Visual Studio Code, Copilot CLI et l’application GitHub Copilot. GitHub présente cette évolution comme une première étape vers une sélection de modèles plus personnalisable.
L’entreprise ne publie toutefois aucun évaluation comparative indiquant la différence de coût, de latence ou de qualité entre les trois niveaux. Elle ne décrit pas non plus une règle déterministe permettant de savoir quel modèle sera choisi pour une requête donnée. Les équipes ne doivent donc pas transformer les étiquettes en pourcentages supposés d’économie ou de performance.
L’intérêt technique est ailleurs : un produit de programmation multi-modèles expose désormais l’intention du routage comme un contrôle de premier ordre, tout en conservant séparément la facturation et les politiques d’autorisation des modèles.
Cette distinction est utile : « privilégier le moins cher » n’est pas équivalent à « ne jamais dépasser ce budget », pas plus que « privilégier la qualité » ne signifie « toujours utiliser le modèle le plus puissant ».