
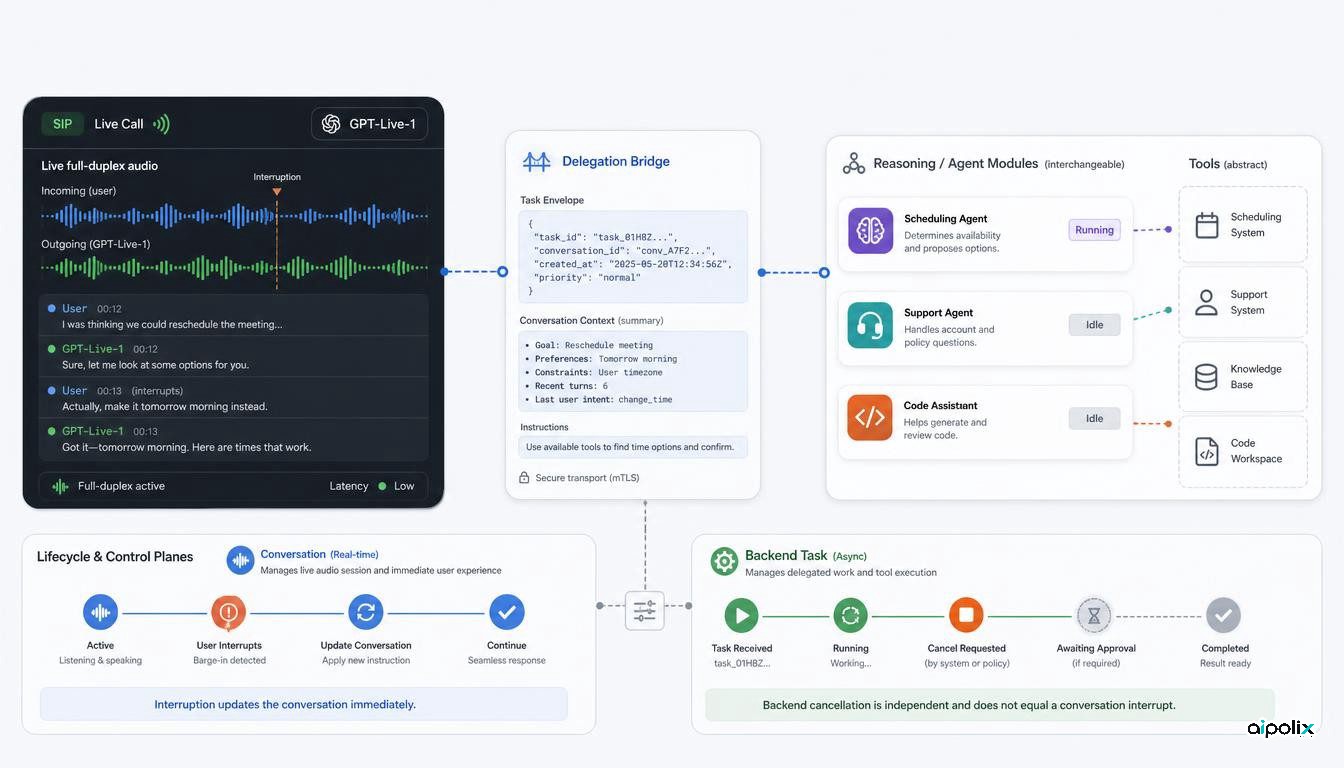
OpenAI met GPT-Live-1 à la disposition des développeurs dans son API. Le modèle vocal full duplex, déjà utilisé dans ChatGPT, peut gérer la conversation en temps réel tout en confiant le raisonnement approfondi ou l'utilisation d'outils à un autre modèle ou agent.
La couche vocale est facturée 0,05 dollar par minute, tandis que le modèle et les outils utilisés en arrière-plan sont facturés séparément. Les équipes doivent donc gérer explicitement l'état, les autorisations et le cycle de vie entre la conversation et le travail délégué.
Le rythme de la conversation est géré par le modèle
Les architectures vocales classiques enchaînent souvent reconnaissance vocale, modèle de langage et synthèse de la parole. OpenAI indique que GPT-Live-1 traite ensemble l'audio entrant et sortant, ce qui lui permet de réagir plus directement aux interruptions, hésitations, acquiescements et bruits environnants.
La version API prend aussi en charge la téléphonie. La référence d'OpenAI montre qu'une session SIP entrante peut être acceptée avec gpt-live-1. Le service fournit des transcriptions, le texte des réponses, une détection des tours de parole, des indications lexicales et des réglages de ton, de rythme et de style.
OpenAI annonce un gain de 30 points de pourcentage face à GPT-Realtime-2.1 sur son Full Duplex Bench et une première place sur Tau3 lorsque GPT-Live-1 est associé à GPT-6 Astra. Ces résultats viennent du fournisseur et doivent être vérifiés sur les charges de travail réelles.
Conversation et travail peuvent suivre deux chemins
GPT-Live-1 n'a pas besoin d'assurer lui-même tout le raisonnement ni tous les appels d'outils. OpenAI permet de déléguer ces tâches à GPT-6 Astra, à un autre modèle OpenAI ou à un modèle tiers. L'exemple officiel montre du contexte conversationnel envoyé à Codex, puis la réponse réinjectée dans la session vocale.
Cette architecture permet de conserver une couche vocale rapide tout en choisissant le moteur de raisonnement selon la tâche. La contrepartie est l'existence de deux cycles d'exécution. L'utilisateur peut interrompre ou corriger sa demande alors que le travail délégué continue. La session vocale possède son propre état, tandis que le traitement en arrière-plan conserve séparément l'état de la tâche, les permissions et les appels d'outils.
Interrompre la voix ne signifie pas arrêter l'action
L'analyse d'Aipolix est que cette architecture oblige à traiter l'annulation comme une fonction explicite. Dans un chatbot classique, arrêter la génération donne souvent l'impression que le travail s'arrête aussi. Avec une délégation en arrière-plan, arrêter la parole et interrompre l'action sont deux opérations différentes.
Prenons un agent qui commence une réservation, modifie un paramètre de compte ou confie une modification de code à un autre agent. Si l'utilisateur l'interrompt pour dire qu'il ne veut finalement plus de cette action, la couche vocale peut se taire immédiatement. L'application doit toutefois décider séparément si la tâche déléguée doit être annulée, achevée ou suspendue.
Chaque délégation devrait avoir une identité, une portée et un état de cycle de vie permettant de la rapprocher de la dernière intention de l'utilisateur. Les journaux doivent relier la demande orale, la délégation créée, le modèle ou l'agent destinataire, les outils appelés et l'effet externe final.
Le problème devient plus important pour les tâches longues ou celles qui modifient un système externe. Le full duplex améliore précisément l'expérience parce que conversation et travail peuvent se chevaucher. Ce chevauchement accroît aussi le risque que la demande actuelle de l'utilisateur et le travail encore en cours ne correspondent plus.
Le coût réel comporte deux couches
Le tarif de 0,05 dollar par minute ne couvre que la couche vocale frontale. Le coût d'une tâche dépend aussi des jetons du modèle secondaire, des appels d'outils, des reprises et du niveau de raisonnement choisi.
Cette souplesse facilite l'optimisation par cas d'usage, mais le prix par minute de voix ne suffit pas pour comparer des solutions. Une évaluation réaliste doit mesurer le coût jusqu'à la tâche terminée : durée audio, consommation du modèle délégué, outils appelés et fréquence des escalades vers un raisonnement plus coûteux.
La sécurité suit la même séparation
La fiche de sécurité GPT-Live précise que le modèle vocal dispose de protections au niveau du système et que les tâches déléguées héritent des protections du modèle qui les exécute. OpenAI souligne aussi que GPT-Live, sans délégation, ne dispose pas seul d'un large accès aux outils ni d'une capacité d'exécution de code.
Le niveau de risque dépend donc de l'ensemble de l'architecture : modèle vocal, modèle secondaire, outils disponibles et politique d'autorisation de l'application.
Pour un agent vocal en production, les contrôles doivent traverser ces couches. La conversation doit rester encadrée dans la session Live, les outils et les actions doivent être autorisés dans le moteur de fond, et l'application doit conserver le lien entre chaque délégation et l'instruction utilisateur qui l'a déclenchée.
L'arrivée de GPT-Live-1 dans l'API est ainsi un changement d'architecture autant qu'une évolution de la voix. Elle offre une conversation continue à l'avant et des moteurs de raisonnement interchangeables à l'arrière. Pour en tirer parti sans perdre le contrôle, délégation, annulation, permissions, observabilité et coût doivent être conçus explicitement.