
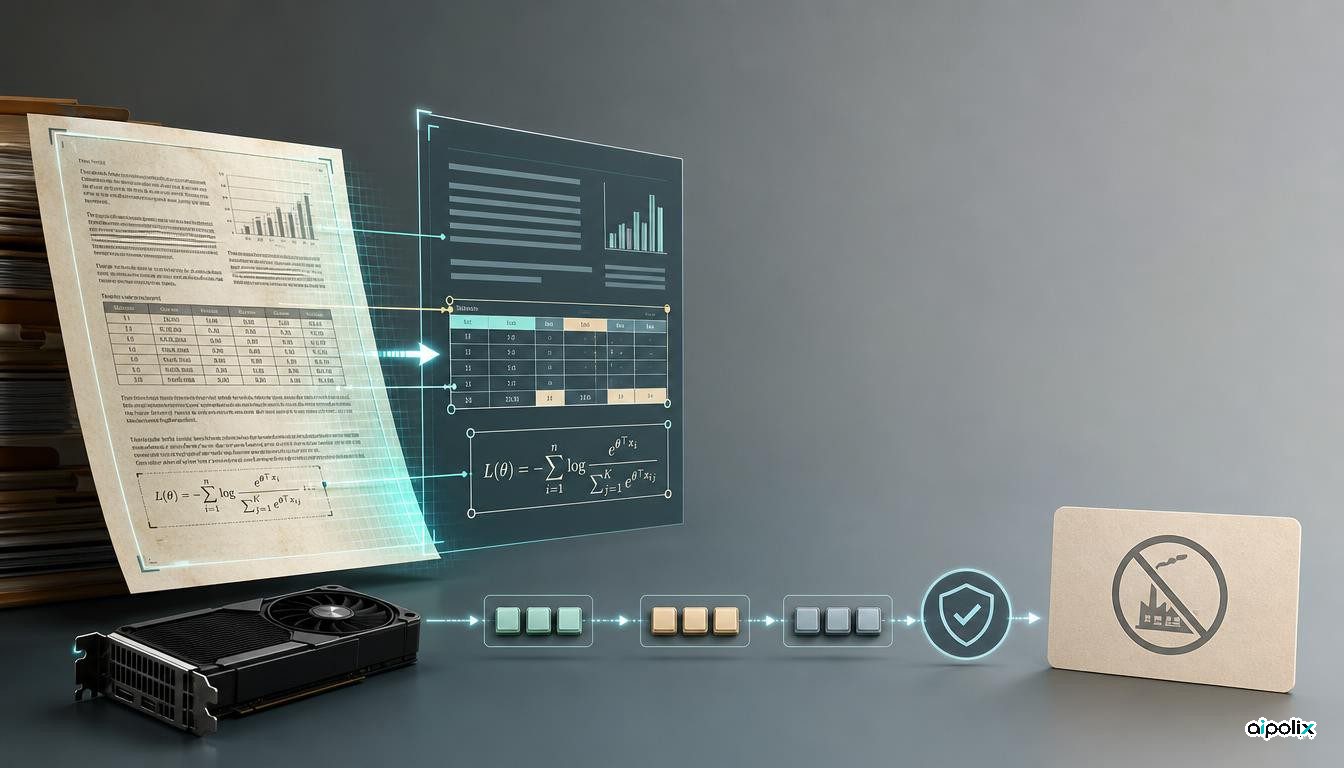
Jina AI a publié le 17 septembre 2026 une présentation technique de Jina-OCR-v1, un modèle capable d'extraire le contenu d'images de documents en conservant autant que possible l'ordre de lecture, les tableaux et les formules. Les poids et le code nécessaires à son chargement sont disponibles sur Hugging Face. Pour les entreprises qui traitent des archives, des rapports ou des documents scientifiques, reconnaître les mots ne suffit pas : les éléments extraits doivent rester exploitables dans une recherche ou une application métier.
L'article scientifique consacré au modèle avait déjà été déposé sur arXiv le 2 septembre. Les mesures de rapidité et de précision proviennent des auteurs ; elles ne constituent pas une garantie pour les documents d'un client. Autre réserve décisive : les poids sont distribués sous licence CC BY-NC 4.0. Une utilisation commerciale nécessite un accord distinct. La publication d'un modèle téléchargeable n'autorise donc pas automatiquement son intégration à un service marchand.
Retrouver les relations entre les éléments d'une page
Le système reprend l'architecture de DeepSeek-OCR. Selon la documentation et l'article, son dispositif de traitement de l'image condense une vue globale de 1 024 pixels sur 1 024 en 256 unités visuelles, tout en pouvant examiner des zones locales plus détaillées. Le composant qui génère le texte compte environ trois milliards de paramètres, mais n'en mobilise qu'environ 570 millions pour chaque unité produite. Ces chiffres décrivent le modèle ; ils ne permettent pas, à eux seuls, de prévoir la mémoire nécessaire ou le débit obtenu sur n'importe quel matériel.
Selon les consignes, le résultat peut prendre la forme de texte suivant l'ordre de lecture, de Markdown, de tableaux HTML ou d'expressions LaTeX. Cette structure fait toute la différence pour un usage professionnel. Un chiffre exact, mais rattaché à la mauvaise colonne d'un tableau, devient une information trompeuse. Une erreur dans la notation d'une formule peut en modifier le sens. L'évaluation doit donc vérifier séparément les relations entre cellules, les expressions mathématiques et les passages omis, au lieu de se limiter à une note globale de reconnaissance de caractères.
La fiche du modèle décrit une exécution avec Transformers, une autre avec vLLM ainsi qu'un service distant doté d'une interface compatible avec celle d'OpenAI. Dans l'exemple Transformers, l'option trust_remote_code=True autorise l'exécution de code spécifique au dépôt. Avant de traiter des documents confidentiels, une équipe doit examiner ce code, ses dépendances et la version du modèle qu'elle installe. Le fait qu'une méthode soit documentée ne constitue pas une certification de sécurité.
Ce que mesurent les gains de vitesse annoncés
Les chercheurs ont ajouté FastMTP, un mécanisme qui propose à l'avance plusieurs unités de texte et fait vérifier ces propositions par le décodeur principal. Leur configuration prévoit trois positions anticipées. D'après l'article, la vérification conserve exactement la suite de sortie obtenue avec le décodage déterministe de référence. Cette propriété ne signifie pas que la transcription est exempte d'erreurs : elle signifie seulement que les deux méthodes de génération aboutissent au même texte.
Dans leurs essais, les auteurs annoncent 91,14 sur OmniDocBench v1.6, 83,4 sur olmOCR-Bench et un débit de 2,57 pages par seconde dans les conditions retenues pour la comparaison. Sur une carte NVIDIA L4, FastMTP doublerait approximativement la vitesse de la phase de génération par rapport au décodage classique. La mesure en pages par seconde et l'accélération du seul décodage ne sont pas interchangeables. Le chargement des images, leur résolution, les agrandissements locaux, le traitement en lots et la longueur du résultat influent aussi sur la durée totale.
Le protocole d'entraînement complémentaire comprend des vérifications programmatiques des formules, des tableaux et de la structure, avec une évaluation graduée des réponses partiellement correctes. Les données mêlent corpus publics nettoyés et pages artificielles conçues pour les exercices difficiles. Ces choix fournissent une explication technique de l'approche, mais ne démontrent pas à eux seuls son efficacité sur des photographies floues, des écritures manuscrites ou les formulaires propres à une entreprise.
Pour comparer des solutions, compter les pages vraiment utilisables
Le nombre d'unités textuelles produites par seconde peut induire en erreur : un système qui génère davantage de texte pour la même page peut afficher un débit élevé tout en terminant plus tard. La vitesse de traitement des pages apporte une indication plus pertinente, mais elle néglige encore le travail nécessaire pour corriger un tableau ou reprendre une page mal lue.
L'analyse d'Aipolix conduit à recommander un essai sur un échantillon représentatif de documents pour lesquels l'organisation possède les droits nécessaires. Trois mesures doivent être relevées ensemble : la proportion de pages atteignant un seuil de qualité défini avant le test, le temps total avec les nouvelles tentatives et le coût du calcul. Il faut ensuite déterminer le coût par page acceptée, et non uniquement par page envoyée au système. Le contrôle des tableaux doit porter sur l'association des lignes et des colonnes ; celui des formules, sur les symboles exacts ; celui du texte courant, sur l'ordre et les omissions.
Cette précaution est importante lorsqu'un moteur de recherche alimente ensuite un assistant. Un chiffre associé à la mauvaise cellule peut être indexé puis reproduit dans une réponse accompagnée d'une citation apparemment convaincante. C'est une conséquence technique de la chaîne d'extraction et de recherche, non une garantie ou une conclusion expérimentale formulée par Jina AI sur tous les assistants. Conserver le lien entre chaque élément extrait et l'image de sa page facilite les vérifications en cas de doute.
La licence fait partie du cahier des charges
La fiche sur Hugging Face indique CC BY-NC 4.0 pour les poids et invite à prendre contact en vue d'un usage commercial. Cette licence ne confère pas une liberté générale d'exploitation commerciale. Une entreprise doit donc régler cette question avant d'utiliser les poids dans un produit payant ou dans son activité. L'accès au service hébergé ne vaut pas licence d'auto-hébergement : les conditions contractuelles de l'API et celles des fichiers téléchargés doivent être examinées séparément.
Le modèle est présenté comme adapté à plusieurs types de documents et de langues. Les performances sur les documents réels d'une organisation, notamment les scans de mauvaise qualité, les petites notes ou les tableaux denses, restent cependant à vérifier avec des réponses de référence établies par des humains. Jina-OCR-v1 met à disposition une piste technique intéressante pour accélérer l'extraction structurée. Son adoption doit être décidée à partir de la qualité obtenue sur place, du coût complet, de l'examen du code exécuté et des droits d'utilisation, plutôt que sur un classement pris isolément.