
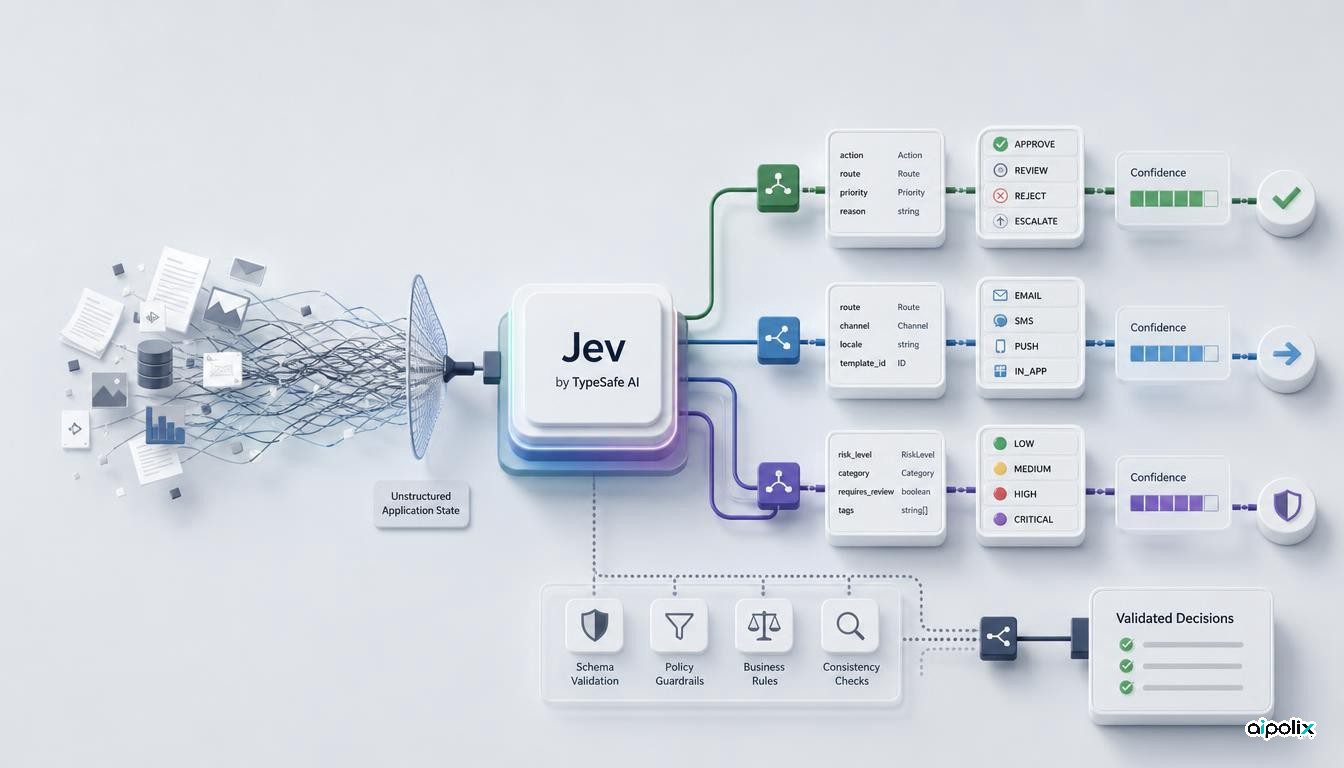
TypeSafe AI présente Jev, son premier modèle public dans une famille baptisée « System One Models ». Plutôt que de produire du texte libre, Jev vise les décisions rapides et structurées intégrées directement dans les logiciels. Le modèle est disponible en accès anticipé. Selon l’entreprise, il renvoie des valeurs typées assorties de probabilités et d’un niveau de confiance.
L’intérêt de cette annonce ne réside donc pas dans un nouveau chatbot. TypeSafe propose une interface plus étroite entre l’IA et le programme : le logiciel définit à l’avance les sorties autorisées, le modèle analyse un état non structuré, puis renvoie une décision que le code peut traiter directement. Cette spécialisation sacrifie la souplesse de la génération libre au profit d’une frontière plus facile à contrôler.
Une IA pensée pour les décisions internes au logiciel
Jev n’est pas conçu pour rédiger des réponses ouvertes. TypeSafe le présente comme l’équivalent d’un appel de fonction doté d’une intelligence de haut niveau : l’entrée peut être non structurée, mais la sortie respecte un type défini à l’avance.
Cette approche cible notamment le classement, le routage, l’extraction, la notation ou le choix entre plusieurs branches d’un programme. Un LLM classique peut lui aussi être contraint à produire du JSON ou à respecter un schéma, mais il génère toujours sa réponse séquentiellement et l’application doit généralement la valider. Avec Jev, l’espace des réponses possibles fait partie de l’interface du modèle.
TypeSafe indique que Jev gère directement jusqu’à 255 choix. Dans sa démonstration Wikiracing, lorsque le nombre d’options dépasse cette limite, le système procède en deux étapes : il attribue d’abord un score aux options, puis effectue un choix explicite. Cette limite rappelle que Jev est un modèle spécialisé, et non un substitut universel aux modèles génératifs.
Des chiffres de vitesse et de coût à confirmer
TypeSafe annonce une latence de bout en bout comprise entre 70 et 500 millisecondes. Pour les requêtes correspondant au profil visé, l’entreprise avance un gain de vitesse de 40 à 200 fois par rapport à des modèles de pointe. Ses propres évaluations de processus affichent même, dans certains cas, 193,6 fois plus de vitesse et un coût 444,6 fois inférieur.
Ces résultats proviennent du fournisseur et ne constituent pas encore une validation indépendante. TypeSafe expose d’ailleurs plusieurs réserves. Ses évaluations utilisent comme référence la moyenne des probabilités produites par de grands modèles externes, plutôt qu’une vérité de référence établie indépendamment. Les scénarios ont aussi été conçus par des membres de l’équipe chargée des capacités du modèle, ce qui peut introduire un biais.
Le tarif annoncé est de 0,042 dollar par million de jetons en entrée. TypeSafe considère le coût des décisions en sortie comme trop faible pour être facturé séparément. L’entreprise précise toutefois qu’un tarif public ne permet pas de démontrer l’absence de subvention du service. La viabilité économique à long terme reste donc à vérifier.
La promesse « sans hallucination » doit être précisée
TypeSafe affirme que Jev ne peut pas halluciner. Pour un ingénieur, la garantie la plus solide est plus limitée : puisque le modèle ne peut renvoyer que des valeurs appartenant au type défini, il ne peut pas inventer un champ hors schéma ni produire librement un appel d’outil textuel. C’est une propriété structurelle utile.
Elle ne garantit pas pour autant que la décision autorisée soit correcte. Un classificateur peut respecter parfaitement son type tout en choisissant la mauvaise catégorie. TypeSafe cherche à traiter ce problème avec des probabilités calibrées et des scores de confiance, mais leur qualité devra être testée sur davantage de domaines et par des acteurs indépendants.
Pour une équipe de développement, cette distinction est essentielle. La sûreté de type peut éliminer une catégorie d’erreurs sans supprimer l’erreur sémantique. Des seuils de confiance, des solutions de repli, de la supervision et des critères d’acceptation restent nécessaires lorsque le coût d’une mauvaise décision est élevé.
Ce que cela change pour l’architecture des agents
L’implication la plus intéressante concerne les systèmes agentiques. Beaucoup d’entre eux sollicitent un grand modèle génératif à chaque étape, y compris pour des décisions modestes : choisir un outil, orienter une requête, approuver une action candidate ou classer un état. Dans un processus long, la latence et le coût de ces appels s’additionnent.
Un modèle spécialisé ouvre une autre possibilité. Les modèles génératifs peuvent rester réservés aux tâches qui exigent réellement synthèse ou raisonnement ouvert, tandis qu’un modèle borné prend en charge les décisions fréquentes et rapides. Si les résultats de TypeSafe sur le coût, la vitesse et la calibration se confirment hors de ses propres évaluations, cette séparation pourrait rendre les architectures multi-modèles plus intéressantes.
Elle modifie aussi la frontière de contrôle. Lorsque le programme fixe l’espace des sorties avant l’inférence, certaines contraintes sont imposées par le logiciel plutôt que par une consigne en langage naturel. Cela ne suffit pas à rendre un agent autonome sûr, mais réduit la part d’autorité confiée à une génération sans contrainte.
Un accès anticipé qui laisse plusieurs questions ouvertes
Jev n’en est qu’à l’accès anticipé. TypeSafe publie des évaluations de processus ainsi que des démonstrations, notamment Doom et Wikiracing, mais on manque encore de données indépendantes sur la fiabilité, la calibration, la stabilité des prix et le comportement dans des domaines nouveaux.
Il est donc plus prudent de voir cette sortie comme une proposition d’architecture concrète que comme la preuve du remplacement des LLM généralistes. Jev renonce volontairement à la génération de texte pour optimiser un problème plus étroit. Reste à savoir si ce problème est suffisamment fréquent dans les logiciels réels et si les performances se maintiennent sur des charges conçues hors de TypeSafe.
Pour les équipes d’IA, la comparaison utile est très concrète : déterminer si certains nœuds d’un processus peuvent remplacer un appel génératif coûteux par une décision bornée, sans augmenter les erreurs sémantiques ni la complexité d’exploitation.