
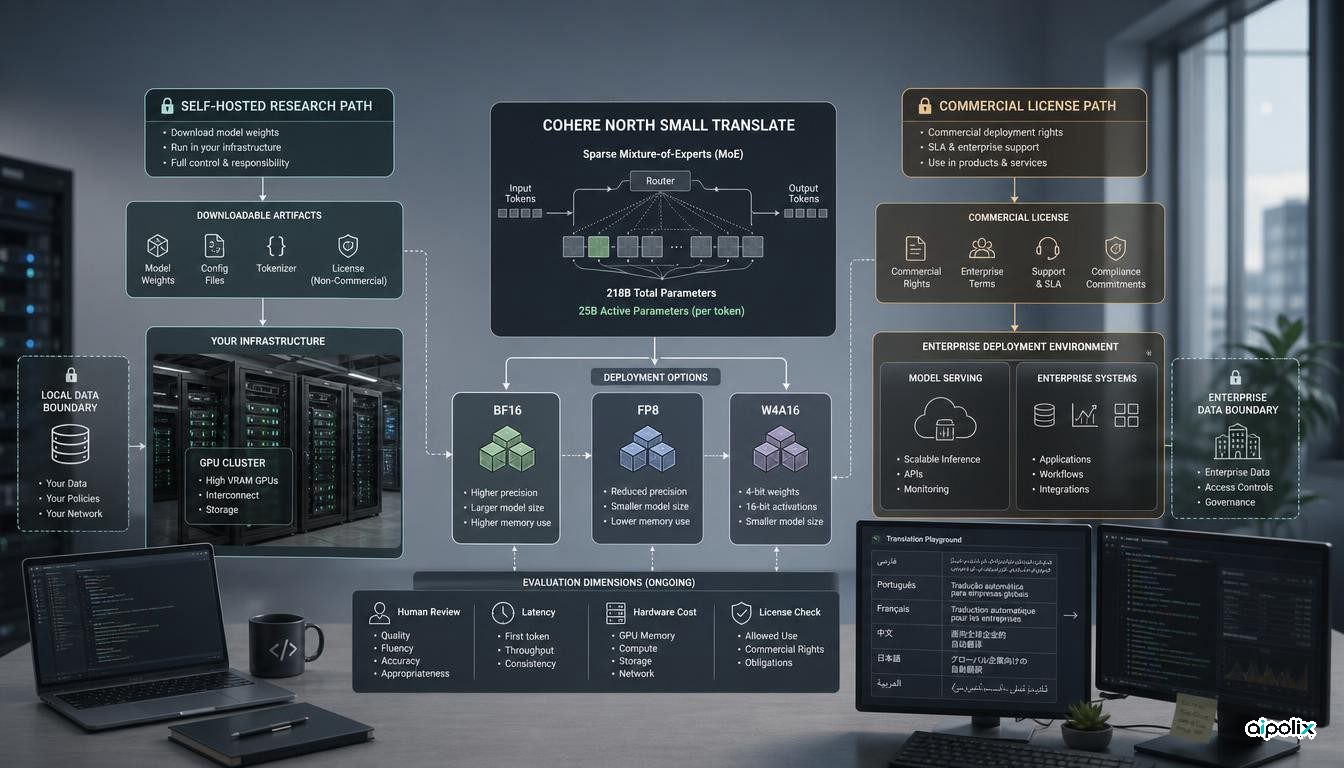
A Cohere lançou o North Small Translate, um modelo especializado em tradução cujos pesos podem ser descarregados e executados fora do serviço alojado da empresa. O modelo usa uma arquitetura MoE com 218 mil milhões de parâmetros no total, 25 mil milhões ativos por token, suporte para 50 línguas e contexto de 16K tanto na entrada como na saída. Estão disponíveis checkpoints BF16, FP8 e NVFP4 W4A16, além do acesso por API.
Há, porém, uma condição essencial na licença. Os pesos públicos são distribuídos sob CC BY-NC 4.0 e sujeitos às regras de utilização da Cohere Labs. Isso permite investigação, avaliação e utilizações não comerciais, mas não concede automaticamente direitos para exploração comercial. Para esse cenário, a Cohere indica uma licença separada e o Model Vault.
Ter acesso aos pesos não significa ter licença comercial
A expressão «pesos abertos» descreve sobretudo a possibilidade técnica de obter e executar o modelo. Não significa que qualquer utilização seja permitida. No caso do North Small Translate, uma equipa pode descarregar os ficheiros do Hugging Face, consultar a ficha técnica e executá-los na sua própria infraestrutura depois de aceitar as condições do repositório, mas a licença pública continua a ser explicitamente não comercial.
Para equipas de arquitetura e compras, esta diferença é tão importante como a qualidade. A existência dos ficheiros não permite concluir que uma empresa os pode incorporar num produto pago, redistribuir uma versão derivada ou executar uma carga comercial ao abrigo da licença pública. Esses direitos têm de ser confirmados no acordo comercial oferecido separadamente pela Cohere.
A análise da Aipolix é que a soberania tem aqui duas dimensões independentes: controlo técnico sobre o local onde a inferência é executada e controlo jurídico sobre os direitos de utilização. Executar o modelo em infraestrutura própria pode melhorar a residência dos dados e o controlo operacional, mas não elimina as limitações da licença.
Vinte e cinco mil milhões de parâmetros ativos continuam a exigir muito hardware
O North Small Translate é um modelo MoE esparso com 218 mil milhões de parâmetros totais e 25 mil milhões ativos por token. A ficha do modelo descreve 128 especialistas, dos quais oito são selecionados em cada token, além de especialistas partilhados.
O número de parâmetros ativos pode fazer o modelo parecer mais pequeno do que é na prática. A Cohere indica como mínimo oito H100 ou quatro B200 para BF16, quatro H100 ou dois B200 para FP8, e dois H100 ou um B200 para a variante NVFP4 W4A16. A ficha desta última refere que a quantização reduz a ocupação aproximada de 437 GB para 131 GB.
Isto torna o modelo possível de alojar por organizações com aceleradores modernos, mas não o transforma num modelo local leve para hardware corrente de desenvolvimento. Uma comparação com serviços de tradução por API deve incluir aquisição ou aluguer de GPU, utilização efetiva, concorrência e custos operacionais, em vez de olhar apenas para os resultados de qualidade.
A liderança nos benchmarks continua a ser um resultado do fornecedor
A Cohere divulga 83,60 pontos na sua avaliação WMT26 agregada e 84,36 para um modo Agentic de várias passagens que procura e corrige erros de tradução. O anúncio compara estes números com DeepL, Google Translate e vários modelos com pesos disponíveis. A empresa também afirma ter maior débito do que o Gemma 4 31B em testes internos e bons resultados em documentos longos.
Estes números são úteis como motivo para testar o modelo, mas não constituem validação independente. A Cohere explica que a comparação WMT26 utiliza GPT-5.6-Sol como avaliador, enquanto a avaliação de contexto longo usa xCOMET-XL por parágrafo. O material de lançamento não apresenta uma avaliação humana independente para todas as línguas suportadas.
Na tradução, uma média elevada pode esconder diferenças grandes entre pares linguísticos, domínios, terminologia e tipos de documento. Um modelo forte em média pode continuar a falhar em linguagem jurídica, nomes próprios, vocabulário de produto, formatação ou numa língua menos representada que seja crítica para um cliente.
Por isso, a tabela da Cohere deve servir para definir o que testar, não para fechar uma decisão de compra. Uma avaliação de produção deve incluir revisão humana bilingue nos pares linguísticos e nos documentos reais da organização.
O modo Agentic também muda aquilo que está a ser medido
O resultado superior do modo Agentic é relevante porque já não corresponde simplesmente a uma geração do modelo. A Cohere descreve-o como um processo capaz de detetar e corrigir erros de tradução.
O anúncio apresenta o ganho de qualidade, mas não publica uma comparação equivalente de custo e latência de ponta a ponta entre esse processo e o modo normal. As equipas devem medir o fluxo completo: quantas passagens são feitas, quanta geração adicional é necessária, como muda a latência e se a melhoria se mantém quando a tradução é revista por pessoas.
Esta é uma distinção importante para qualquer benchmark. Quando existe um processo de revisão ou verificação em redor do modelo, o resultado já mede um sistema e não apenas o modelo de base. Uma qualidade superior pode justificar-se, mas o custo e os novos modos de falha fazem parte da mesma comparação.
Português, francês e persa estão incluídos, mas isso não garante qualidade uniforme
A ficha técnica enumera 50 línguas, incluindo português, francês e persa, além de línguas de várias regiões europeias e asiáticas. Essa amplitude é interessante para produtos multilingues que pretendem manter a tradução em infraestrutura controlada.
A presença de uma língua na lista não prova, contudo, que todos os pares tenham qualidade equivalente. A Cohere publica médias regionais e resultados agregados, não uma avaliação humana independente de cada combinação. Para uma organização que trabalha em português europeu, o teste de aceitação deve usar conteúdo real e avaliar terminologia, registo, pontuação, nomes próprios, formatação e consistência em documentos longos.
O contexto de 16K permite traduzir unidades maiores, mas a coerência entre secções e referências deve ser verificada diretamente e não inferida apenas a partir do tamanho da janela de contexto.
As limitações explícitas tornam o lançamento mais útil
O North Small Translate oferece algo concreto para avaliação: checkpoints descarregáveis, várias quantizações, requisitos de hardware documentados e um modelo criado especificamente para tradução em vez de conversa genérica.
A razão mais forte para o testar não é aceitar a afirmação de que supera todos os concorrentes. É poder avaliar o mesmo modelo em caminhos alojados e auto-geridos, conhecendo antecipadamente a arquitetura, a dimensão operacional e os limites da licença.
Numa utilização comercial, três decisões devem permanecer separadas: se a qualidade é suficiente para as línguas necessárias, se o custo de servir o modelo faz sentido e se a licença escolhida concede os direitos pretendidos. O North Small Translate torna as duas primeiras questões testáveis e a terceira bastante explícita. A expressão «pesos abertos» não substitui nenhuma dessas verificações.