
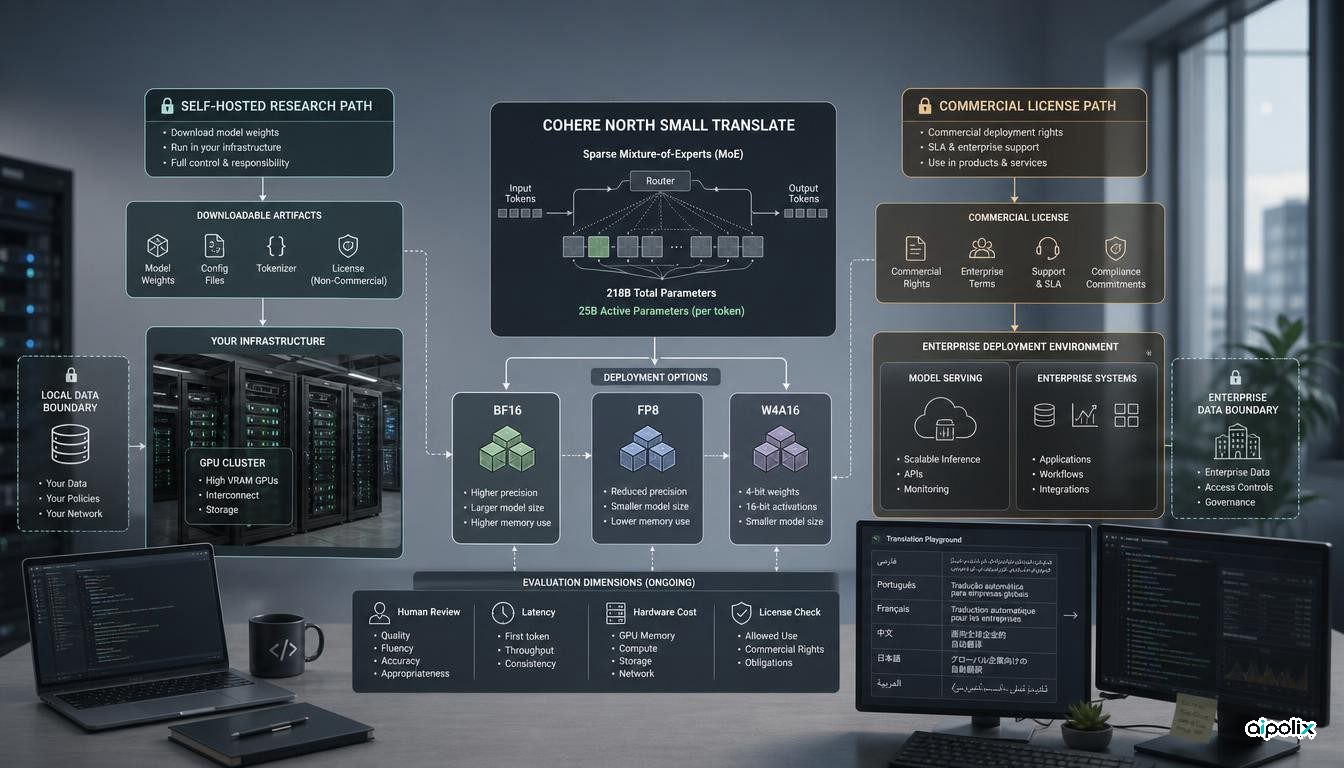
Cohere vient de publier North Small Translate, un modèle spécialisé dans la traduction dont les poids peuvent être téléchargés et exécutés hors de l’infrastructure hébergée de Cohere. Ce modèle à mélange d’experts compte 218 milliards de paramètres au total, en active 25 milliards par jeton, couvre 50 langues et accepte jusqu’à 16K jetons en entrée comme en sortie. Cohere propose des checkpoints BF16, FP8 et NVFP4 W4A16, en plus de son accès par API.
La licence est toutefois une contrainte essentielle. Les poids publics sont distribués sous CC BY-NC 4.0, avec les conditions d’utilisation de Cohere Labs. Ils sont donc disponibles pour la recherche, l’évaluation et les usages non commerciaux, mais ne confèrent pas un droit général d’exploitation commerciale. Pour cet usage, Cohere renvoie vers une licence distincte et Model Vault.
Télécharger les poids ne donne pas automatiquement un droit commercial
L’expression « poids ouverts » décrit surtout un niveau d’accès technique. Elle ne signifie pas nécessairement que tous les usages sont autorisés. North Small Translate l’illustre clairement : une équipe peut récupérer les fichiers sur Hugging Face, examiner la fiche du modèle et l’exécuter sur sa propre infrastructure après avoir accepté les conditions du dépôt, mais la licence publique reste explicitement non commerciale.
Pour les équipes d’architecture et d’achats, cette distinction compte autant que la qualité du modèle. La présence des fichiers ne permet pas de conclure qu’une entreprise peut les intégrer librement à un produit payant, redistribuer un dérivé ou exploiter le modèle pour une charge commerciale sous la licence publique. Ces droits doivent être vérifiés dans l’accord commercial proposé séparément par Cohere.
L’analyse d’Aipolix est que la notion de souveraineté comporte ici deux dimensions indépendantes : la maîtrise technique du lieu d’inférence et les droits juridiques accordés par la licence. L’auto-hébergement peut améliorer la maîtrise des données et de l’exploitation, sans supprimer les restrictions contractuelles.
Vingt-cinq milliards de paramètres actifs restent exigeants
North Small Translate repose sur une architecture MoE parcimonieuse avec 218 milliards de paramètres au total et 25 milliards activés par jeton. La fiche technique décrit 128 experts, dont huit sont sélectionnés pour chaque jeton, en plus d’experts partagés.
Le chiffre de 25 milliards peut donner l’impression d’un modèle relativement compact, mais son empreinte de déploiement reste importante. Cohere recommande au minimum huit H100 ou quatre B200 pour BF16, quatre H100 ou deux B200 pour FP8, et deux H100 ou un B200 pour la variante NVFP4 W4A16. La fiche de cette dernière indique que la quantification ramène l’empreinte d’environ 437 Go à 131 Go.
Le modèle peut donc être auto-hébergé par une organisation équipée d’accélérateurs récents, mais il ne s’agit pas d’un petit modèle local destiné au matériel courant d’un développeur. Une comparaison avec un service de traduction par API doit intégrer le coût des GPU, leur taux d’utilisation, la concurrence des requêtes et l’exploitation de la plateforme.
Le leadership annoncé dans les benchmarks reste un résultat du fournisseur
Cohere publie un score de 83,60 sur son évaluation WMT26 toutes langues confondues et de 84,36 pour un mode Agentic en plusieurs passes, conçu pour détecter puis corriger des erreurs de traduction. Le billet de lancement compare ces résultats à DeepL, Google Translate et plusieurs modèles à poids disponibles. Cohere revendique aussi un débit supérieur à Gemma 4 31B dans ses tests internes et de meilleurs résultats sur les documents longs.
Ces chiffres constituent des éléments utiles pour décider de tester le modèle, mais pas une validation indépendante. Cohere précise que sa comparaison WMT26 utilise GPT-5.6-Sol comme juge, tandis que l’évaluation de contexte long repose sur xCOMET-XL au niveau des paragraphes. Le lancement ne fournit pas d’évaluation humaine indépendante couvrant l’ensemble des langues prises en charge.
En traduction, une bonne moyenne peut masquer des écarts importants selon la paire de langues, le domaine, la terminologie et le type de document. Un modèle performant en moyenne peut encore rencontrer des difficultés sur des contrats, des noms propres, un vocabulaire métier, la mise en forme ou une langue moins dotée essentielle à un client.
La bonne lecture du tableau de Cohere est donc celle d’un signal à vérifier. Une évaluation de production devrait inclure des réviseurs bilingues sur les langues et les documents réellement utilisés.
Le mode Agentic change aussi l’unité de mesure
Le meilleur score du mode Agentic est intéressant parce qu’il ne mesure plus exactement une génération unique du modèle. Cohere le décrit comme un processus qui repère et corrige les erreurs de traduction.
Le billet publie le gain de qualité, mais ne fournit pas une comparaison équivalente de la latence et du coût de bout en bout entre ce mode et la génération standard. Les équipes doivent donc mesurer l’ensemble du processus : nombre de passes, volume de génération supplémentaire, évolution de la latence et maintien du gain lors d’une révision humaine.
C’est une distinction générale pour les benchmarks. Dès qu’un processus de révision ou de vérification entoure le modèle, la mesure porte sur un système complet. Une meilleure qualité peut être réelle, mais son coût opérationnel et ses modes d’échec doivent être évalués avec elle.
Le français, le portugais et le persan sont couverts, sans garantie de parité
La fiche du modèle énumère 50 langues, dont le français, le portugais et le persan, ainsi que de nombreuses langues européennes et asiatiques. Cette couverture est intéressante pour les produits multilingues qui souhaitent garder la traduction sur une infrastructure contrôlée.
La présence d’une langue dans la liste ne garantit pourtant pas une qualité uniforme pour toutes les paires. Cohere publie des moyennes régionales et des scores agrégés, pas une étude humaine indépendante de chaque combinaison. Pour une organisation, l’acceptation devrait porter sur ses propres documents : terminologie, registre, noms propres, ponctuation, structure et cohérence sur les textes longs.
Les 16K jetons de contexte permettent de traiter des unités plus volumineuses, mais la cohérence terminologique entre sections doit être testée directement plutôt que déduite de la seule longueur de contexte.
Les contraintes explicites rendent le modèle plus facile à évaluer
Le lancement fournit des éléments concrets : checkpoints téléchargeables, plusieurs niveaux de quantification, exigences matérielles documentées et spécialisation claire dans la traduction plutôt que dans la conversation générale.
La meilleure raison de tester North Small Translate n’est donc pas de prendre pour acquise sa supériorité sur tous les concurrents. C’est la possibilité d’évaluer le même modèle sur une voie hébergée et une voie auto-gérée, avec une architecture, une empreinte matérielle et une limite de licence connues à l’avance.
Pour un usage commercial, trois décisions doivent rester distinctes : la qualité pour les langues réellement utilisées, l’économie du déploiement et les droits accordés par la licence choisie. North Small Translate rend les deux premières testables et la troisième particulièrement visible. L’étiquette « poids ouverts » ne doit pas remplacer ces trois vérifications.