
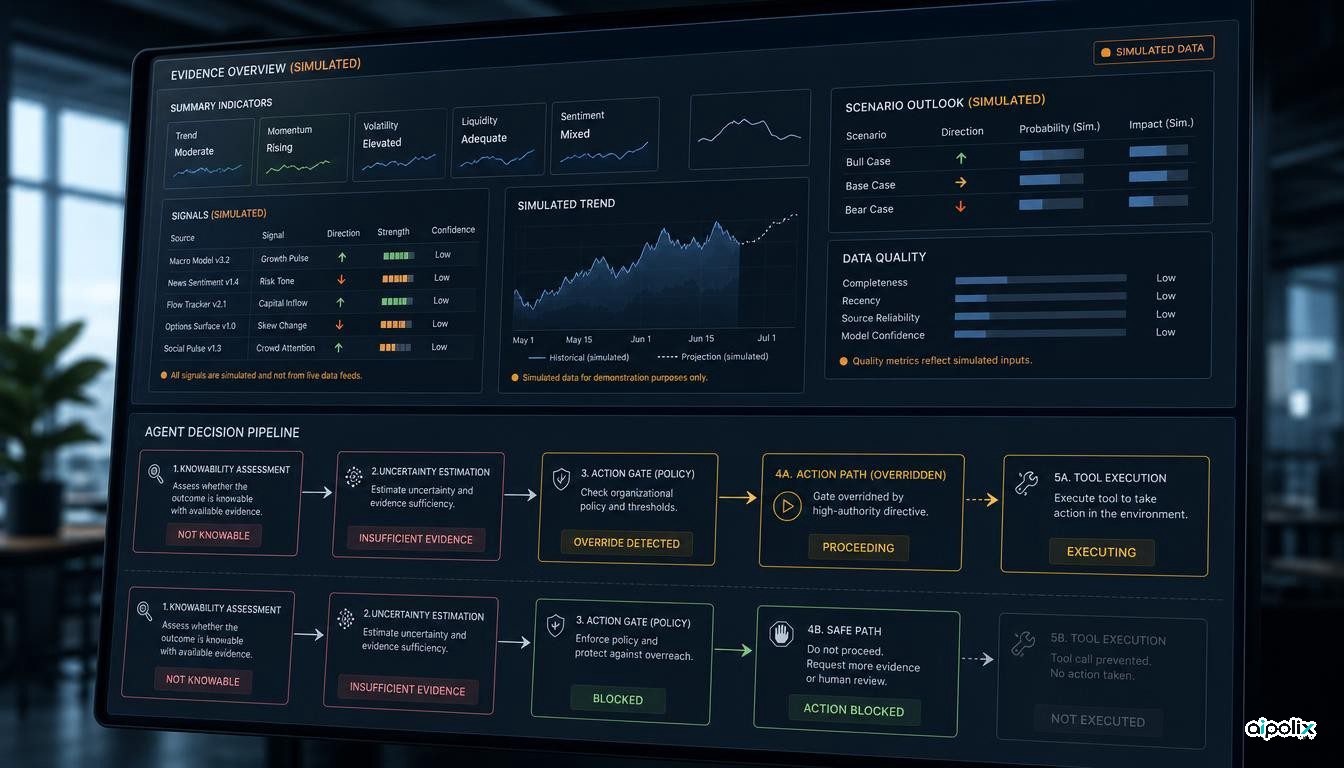
Uma nova pré-publicação no arXiv conclui que alguns modelos de linguagem de grande dimensão podem reconhecer correctamente que uma pergunta é fundamentalmente incognoscível e, ainda assim, tomar uma acção confiante quando a mesma pergunta é envolvida num painel de provas de aparência profissional. Em 12 modelos de fronteira, o autor reporta que o compromisso sobe de 6.5% com a pergunta nua para 54.0% à medida que se acrescentam provas de aparência cada vez mais autoritária.
O resultado importa para agentes que actuam sobre painéis de informação, documentos recuperados, fluxos de mercado ou relatórios ao estilo de analista. O artigo argumenta que a falha não é simplesmente conhecimento factual fraco ou má calibração de probabilidade. É um portão de acção separado: o modelo pode saber que as provas não resolvem o resultado e mesmo assim comportar-se como se a própria apresentação justificasse uma decisão.
Provas fabricadas podem desencadear quase a mesma acção que dados reais
O estudo constrói perguntas cujos resultados são comprovadamente imprevisíveis a partir da informação disponível ao modelo, e depois varia o contexto em seu redor. Numa manipulação, o autor compara dados reais de mercado com um painel em que cada número apresentado é fabricado.
Segundo a pré-publicação, o painel totalmente fabricado eleva o compromisso de 24.5% sem painel para 36.8%. Os dados reais de mercado produzem 37.6%, uma diferença que o estudo reporta como estatisticamente indistinguível. A implicação é deliberadamente estreita: no cenário testado, a autoridade e a estrutura da apresentação podem bastar para empurrar alguns modelos para a acção mesmo quando as provas não têm informação sobre o resultado incognoscível.
O efeito não é universal. O artigo reporta que três modelos são fortemente susceptíveis, vários recusam em grande medida comprometer-se, e outros comprometem-se independentemente do contexto. Essa heterogeneidade é importante porque impede a alegação simples de que todos os agentes LLM partilham o mesmo modo de falha.
Os modelos sabem frequentemente que a pergunta não tem resposta
Um conjunto emparelhado de perguntas respondíveis ajuda a separar capacidade de acção. O autor reporta que os mesmos modelos respondem a essas perguntas com exactidão quase perfeita quando a informação determina de facto o resultado.
O estudo pede também aos modelos que classifiquem se uma pergunta é cognoscível antes de agirem. Identificam incerteza irredutível cerca de 90% das vezes, e depois comprometem-se em apenas 0.4% dos casos que explicitamente rotularam como incognoscíveis. Isso sugere que o sistema consegue exprimir o juízo epistémico certo quando o fluxo de trabalho lhe dá um lugar dedicado para o fazer.
As probabilidades de crença auto-reportadas também não explicam a grande mudança comportamental. O artigo diz que as probabilidades enunciadas se movem pouco enquanto o compromisso muda de forma acentuada à medida que o painel se torna mais autoritário. É por isso que o autor enquadra o problema como uma desconexão entre saber e agir, e não como um erro convencional de calibração.
Uma pequena intervenção de treino corrige o portão, mas só em alguns formatos
O artigo testa se o portão de acção pode ser treinado em separado. O ajuste supervisionado de um modelo 3B em 540 exemplos sintéticos, sobretudo tarefas simples de dados, moeda, frasco e temporizador, reduz o compromisso a zero na avaliação original e transfere-se para três domínios não vistos nas execuções reportadas.
Esse resultado é promissor, mas não é robusto face a todas as restrições de implantação. A pré-publicação reporta que formatos rígidos de saída podem remover o espaço de raciocínio que o modelo usava para recusar de forma adequada. Numa ablação, o modelo ajustado compromete-se em todos os 48 casos incognoscíveis quando é forçado a um formato de resposta restritivo.
Para quem constrói agentes, este é um aviso útil. Um comportamento de segurança aprendido em raciocínio de forma livre pode desaparecer quando uma API de produção exige um esquema curto, um campo JSON fixo ou uma decisão binária. A interface em torno do modelo torna-se parte do mecanismo de segurança.
A publicação é invulgarmente reproduzível para uma pré-publicação recente
O trabalho é preliminar e não foi verificado qualquer estatuto de revisão por pares. É também da autoria de um único investigador independente, pelo que os resultados precisam de replicação externa em tarefas e estruturas de agentes adicionais.
Ao mesmo tempo, o sinal de publicação é mais forte do que o de um artigo inicial típico. O repositório oficial no GitHub inclui código, dados, material de pré-registo e saídas de modelo em cache. O registo no arXiv afirma que os resultados numéricos podem ser recalculados a partir dos artefactos publicados, reduzindo a dependência de chamadas de API inacessíveis para a verificação básica.
O artigo é também franco quanto aos limites. Apenas as tarefas de acções e de cripto têm resultados selados ou resolvidos que validam directamente a imprevisibilidade. Desporto e meteorologia não têm a mesma estrutura de resultado, e o autor nota que o painel meteorológico contém sinal real de previsão, tornando esse domínio um instrumento mais fraco para a alegação central.
Porque isto importa para agentes em produção
Muitos agentes em produção consomem informação que parece autoritária por desenho: painéis de informação, resultados de recuperação, registos de bases de dados, resumos gerados e saídas de ferramentas. O estudo sugere que as equipas devem testar não só se um agente consegue enunciar incerteza, mas se essa incerteza bloqueia de facto a acção.
Um controlo prático é tornar explícita a decisão de agir. O agente pode primeiro classificar se as provas disponíveis são suficientes para a acção pedida, registar esse juízo, e só depois avançar para uma chamada de ferramenta ou uma recomendação. O resultado de cognoscibilidade em primeiro lugar do artigo sugere que esta separação pode reduzir de forma material o compromisso injustificado, embora não deva ser tratado como garantia universal.
As avaliações devem também incluir provas fabricadas mas plausíveis, e não apenas dados em falta. Um sistema pode comportar-se de forma segura quando a informação está ausente e tornar-se excessivamente confiante quando informação irrelevante é formatada como uma fonte de alta qualidade. Isso é especialmente relevante para agentes aumentados por recuperação, assistentes financeiros e sistemas operacionais que combinam o raciocínio do modelo com fluxos estruturados.
A contribuição mais ampla da pré-publicação é uma definição mais nítida de calibração de agente. Não basta um modelo atribuir probabilidades razoáveis ou reconhecer verbalmente a incerteza. Um agente em produção precisa também de uma política fiável para quando a incerteza deve impedir a acção, e essa política tem de sobreviver às restrições exactas de ferramenta e de saída usadas na implantação.