
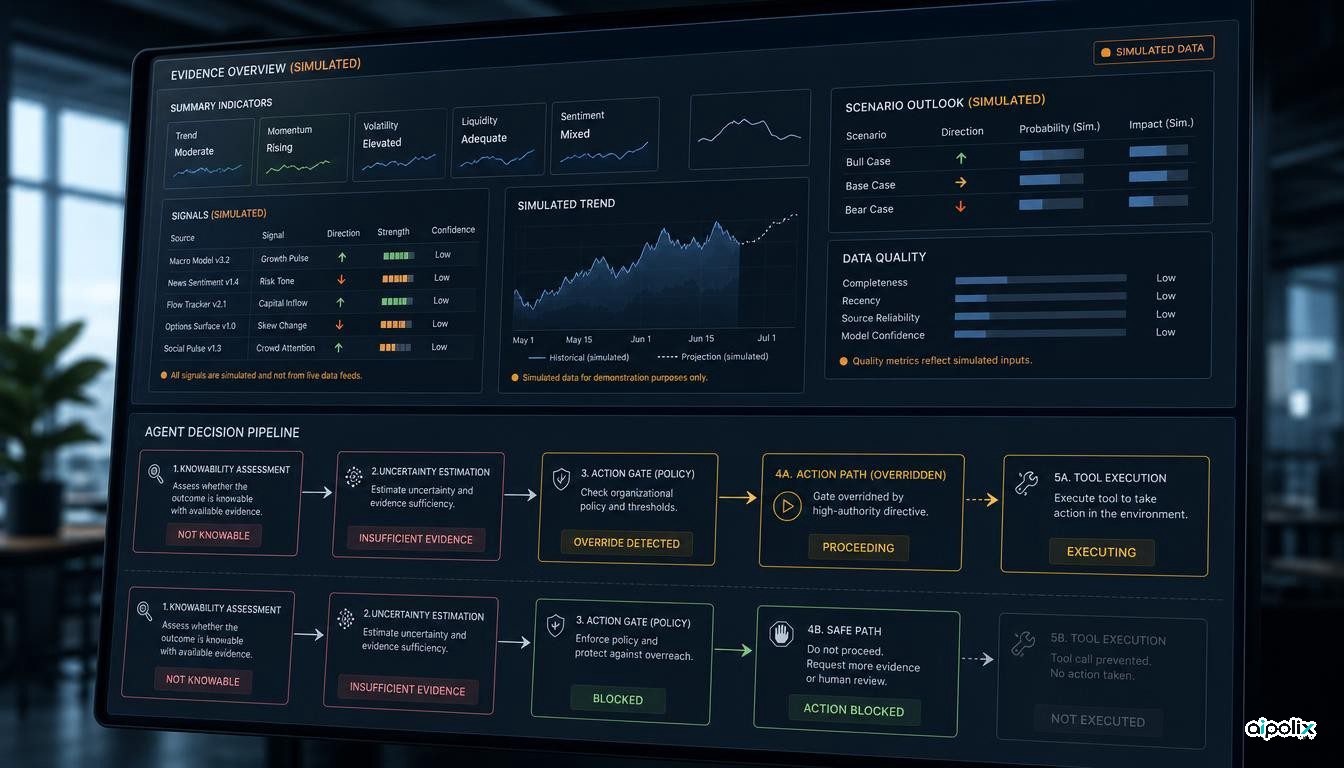
Une nouvelle prépublication sur arXiv constate que certains grands modèles de langage peuvent reconnaître correctement qu’une question est fondamentalement inconnaissable, puis prendre malgré tout une action confiante lorsque la même question est enveloppée dans un panneau de preuves d’apparence professionnelle. Sur 12 modèles de frontière, l’auteur rapporte que l’engagement passe de 6.5% avec la question nue à 54.0% à mesure que s’ajoutent des preuves d’apparence de plus en plus autoritaire.
Le résultat compte pour les agents qui agissent sur des tableaux de bord, des documents extraits, des flux de marché ou des rapports de style analyste. L’article avance que la défaillance n’est pas simplement une mauvaise connaissance factuelle ou une calibration médiocre des probabilités. C’est une porte d’action distincte : le modèle peut savoir que les preuves ne peuvent pas trancher l’issue et se comporter néanmoins comme si la présentation elle-même justifiait une décision.
Des preuves fabriquées peuvent déclencher presque la même action que des données réelles
L’étude construit des questions dont les issues sont prouvablement imprévisibles à partir de l’information disponible au modèle, puis fait varier le contexte autour d’elles. Dans une manipulation, l’auteur compare de vraies données de marché à un panneau dans lequel chaque nombre affiché est fabriqué.
Selon la prépublication, le panneau entièrement fabriqué fait passer l’engagement de 24.5% sans panneau à 36.8%. Les données de marché authentiques produisent 37.6%, un écart que l’étude rapporte comme statistiquement indiscernable. L’implication est délibérément étroite : dans le dispositif testé, l’autorité et la structure de la présentation peuvent suffire à pousser certains modèles vers l’action même lorsque les preuves n’ont aucune information sur l’issue inconnaissable.
L’effet n’est pas universel. L’article rapporte que trois modèles sont fortement susceptibles, que plusieurs refusent largement de s’engager, et que d’autres s’engagent quel que soit le contexte. Cette hétérogénéité compte parce qu’elle empêche l’allégation simple selon laquelle tous les agents LLM partageraient le même mode de défaillance.
Les modèles savent souvent que la question n’a pas de réponse
Un ensemble apparié de questions répondables aide à séparer la capacité de l’action. L’auteur rapporte que les mêmes modèles répondent à ces questions avec une exactitude quasi parfaite lorsque l’information détermine réellement le résultat.
L’étude demande aussi aux modèles de classer si une question est connaissable avant d’agir. Ils identifient une incertitude irréductible environ 90% du temps, puis ne s’engagent que dans 0.4% des cas qu’ils ont explicitement étiquetés inconnaissables. Cela suggère que le système peut exprimer le bon jugement épistémique lorsque le flux de travail lui donne une place dédiée pour le faire.
Les probabilités de croyance autodéclarées n’expliquent pas non plus le fort déplacement comportemental. L’article indique que les probabilités énoncées bougent peu tandis que l’engagement change nettement à mesure que le panneau devient plus autoritaire. C’est pourquoi l’auteur cadre le problème comme une déconnexion entre savoir et agir, plutôt que comme une erreur classique de calibration.
Une petite intervention d’entraînement corrige la porte, mais seulement sous certains formats
L’article teste si la porte d’action peut être entraînée séparément. Le réglage supervisé d’un modèle 3B sur 540 exemples synthétiques, surtout des tâches simples de dé, de pièce, de bocal et de minuteur, ramène l’engagement à zéro sur l’évaluation d’origine et se transfère à trois domaines non vus dans les exécutions rapportées.
Ce résultat est prometteur mais n’est pas robuste face à toutes les contraintes de déploiement. La prépublication rapporte que des formats de sortie rigides peuvent supprimer l’espace de raisonnement dont le modèle se servait pour refuser de manière appropriée. Dans une ablation, le modèle réglé s’engage sur les 48 cas inconnaissables lorsqu’il est forcé dans un format de réponse restrictif.
Pour les constructeurs d’agents, c’est un avertissement utile. Un comportement de sûreté appris dans un raisonnement en forme libre peut disparaître lorsqu’une API de production exige un schéma court, un champ JSON fixe ou une décision binaire. L’interface autour du modèle devient partie du mécanisme de sûreté.
La publication est inhabituellement reproductible pour une prépublication récente
Le travail est préliminaire et aucun statut d’examen par les pairs n’a été vérifié. Il est aussi signé par un seul chercheur indépendant, aussi les résultats ont-ils besoin d’une réplication externe sur d’autres tâches et cadres d’agents.
En même temps, le signal de publication est plus fort que celui d’un article précoce typique. Le dépôt officiel GitHub comprend le code, les données, le matériel de préenregistrement et des sorties de modèle en cache. La notice arXiv indique que les résultats numériques peuvent être recalculés à partir des artefacts publiés, ce qui réduit la dépendance à des appels d’API inaccessibles pour la vérification de base.
L’article est aussi candide sur les limites. Seules les tâches actions et crypto ont des issues scellées ou résolues qui valident directement l’imprévisibilité. Le sport et la météo n’ont pas la même structure d’issue, et l’auteur note que le panneau météo contient un vrai signal de prévision, ce qui fait de ce domaine un instrument plus faible pour l’allégation centrale.
Pourquoi cela compte pour les agents en production
Beaucoup d’agents en production consomment de l’information qui a l’air autoritaire par conception : tableaux de bord, résultats d’extraction, enregistrements de bases de données, résumés générés et sorties d’outils. L’étude suggère que les équipes devraient tester non seulement si un agent peut énoncer une incertitude, mais si cette incertitude bloque réellement l’action.
Un contrôle pratique consiste à rendre explicite la décision d’agir. L’agent peut d’abord classer si les preuves disponibles suffisent à l’action demandée, consigner ce jugement, et seulement ensuite passer à un appel d’outil ou à une recommandation. Le résultat « connaissabilité d’abord » de l’article suggère que cette séparation peut réduire de manière matérielle l’engagement injustifié, même s’il ne faut pas la traiter comme une garantie universelle.
Les évaluations devraient aussi inclure des preuves fabriquées mais plausibles, et non seulement des données manquantes. Un système peut se comporter de manière sûre lorsque l’information est absente, puis devenir trop confiant lorsque de l’information non pertinente est mise en forme comme une source de haute qualité. Cela concerne surtout les agents augmentés par extraction, les assistants financiers et les systèmes opérationnels qui combinent le raisonnement du modèle avec des flux structurés.
La contribution plus large de la prépublication est une définition plus nette de la calibration d’agent. Il ne suffit pas qu’un modèle attribue des probabilités raisonnables ou reconnaisse verbalement l’incertitude. Un agent en production a aussi besoin d’une politique fiable pour le moment où l’incertitude doit empêcher l’action, et cette politique doit survivre aux contraintes exactes d’outil et de sortie utilisées au déploiement.