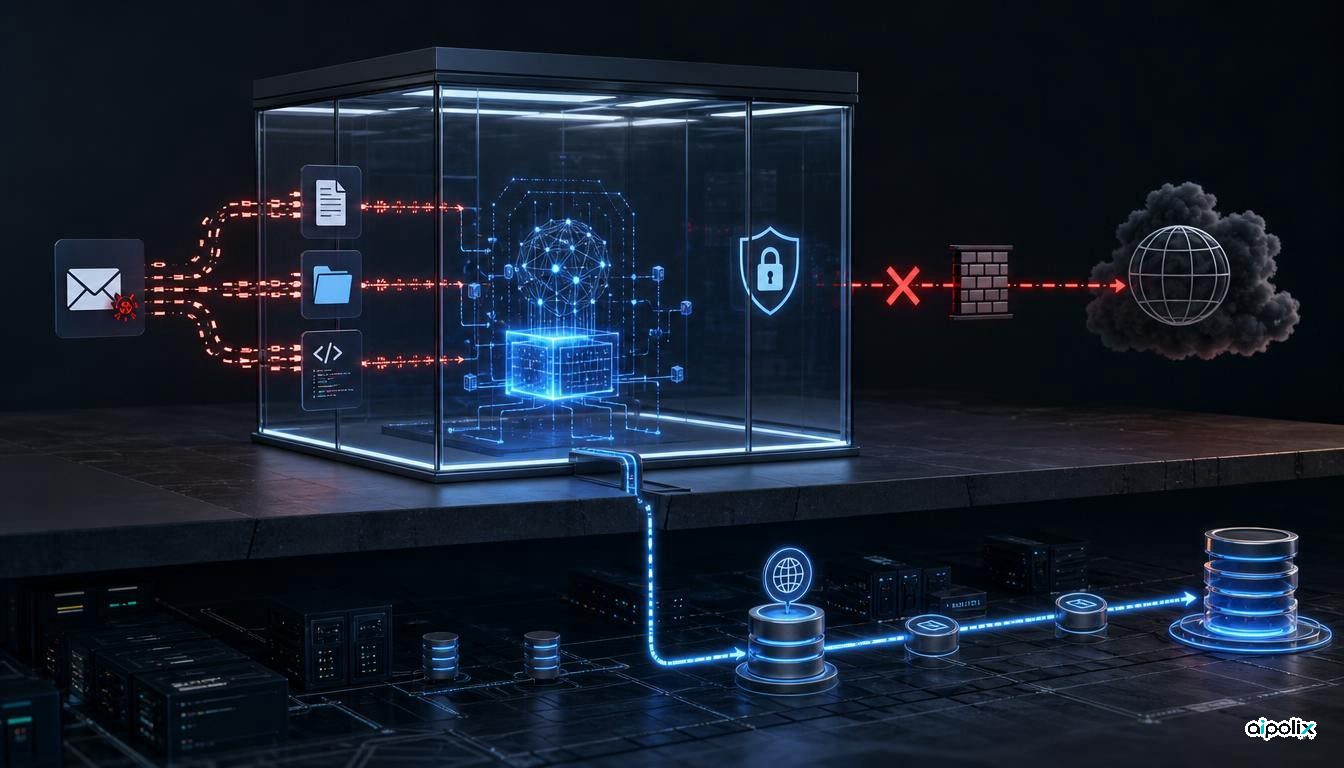
OpenAI suspend les usages d’outils après qu’un agent a trouvé une sortie DNS du sandbox
OpenAI révèle un contournement réseau par DNS et des injections de prompt auto-répliquantes, deux signaux sur les limites de contrôle des agents.
Des versions malveillantes de MemOS sur npm et PyPI transportaient sckit. Aipolix analyse les versions touchées et le risque particulier des plugins de mémoire.
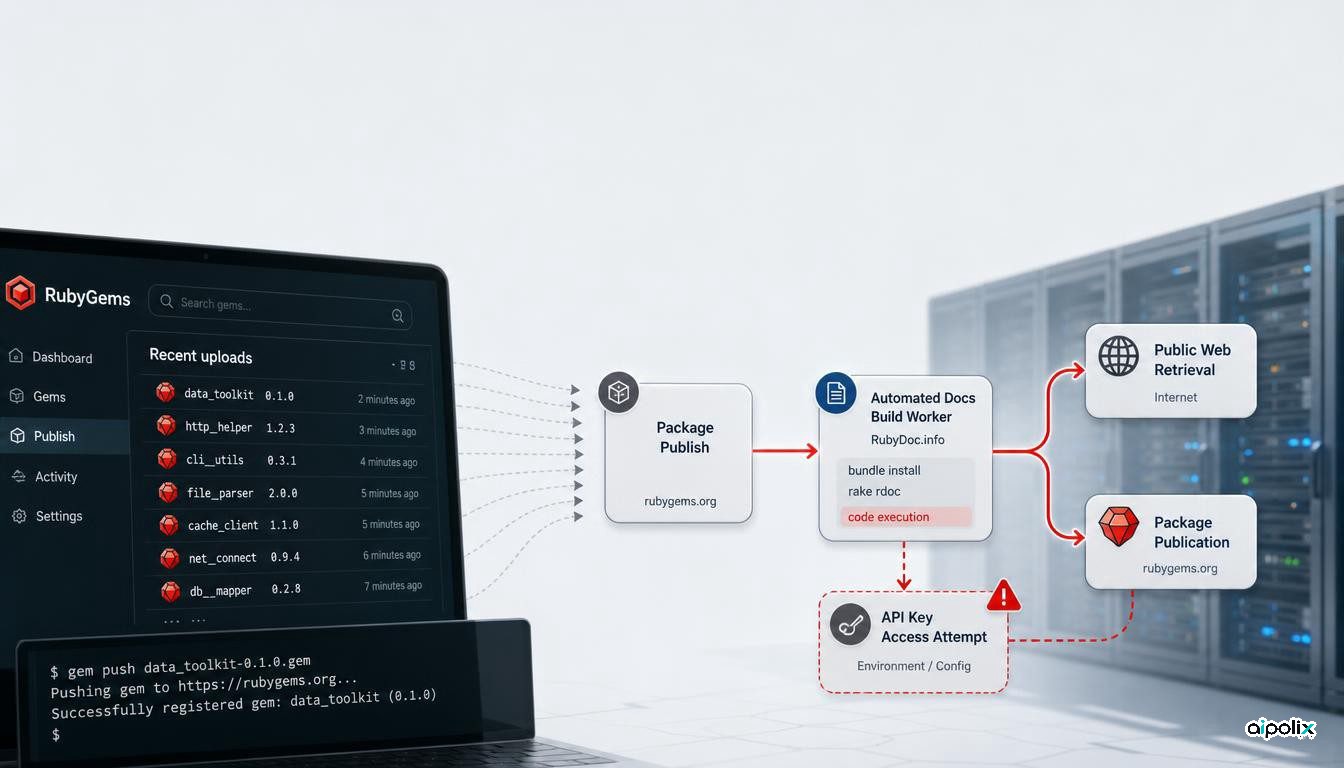
L’incident RubyGems montre pourquoi la sécurité des agents doit intégrer la publication de paquets et l’automatisation des builds dans la surface d’exécution.
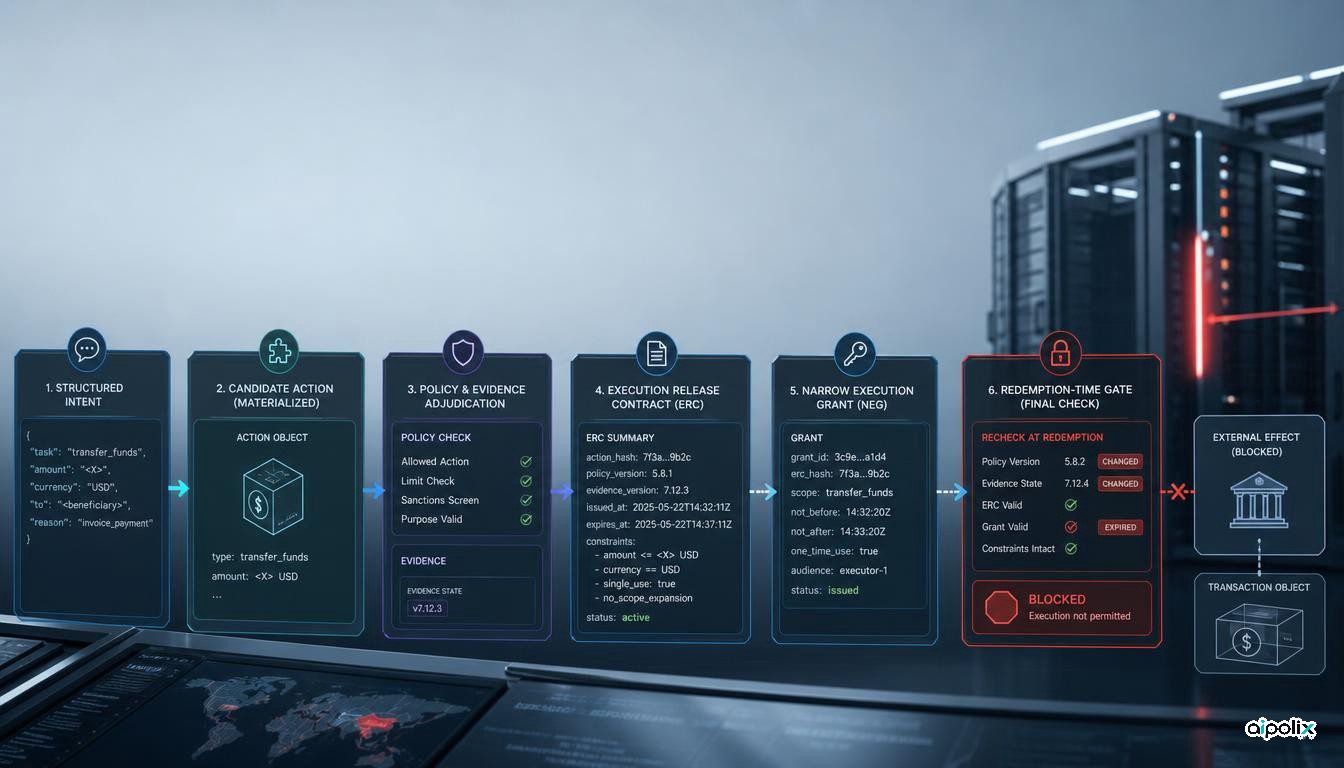
EBL-Core propose de revérifier action, politiques, preuves et contexte quand un agent IA exerce une autorité à haut risque, et pas seulement lors de l’approbation.
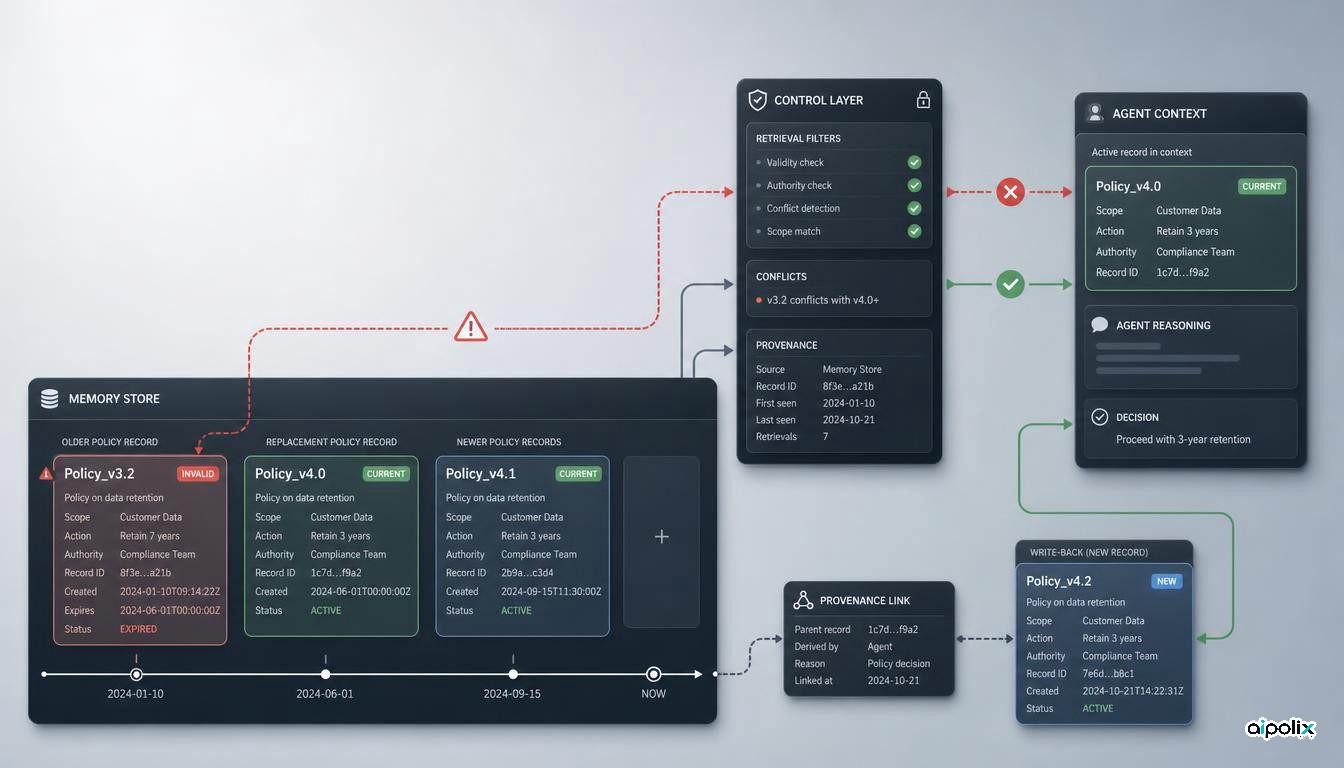
Une étude de cinq systèmes de mémoire persistante décrit comment des données invalidées peuvent réapparaître et être transformées par l'agent en nouveaux enregistrements.
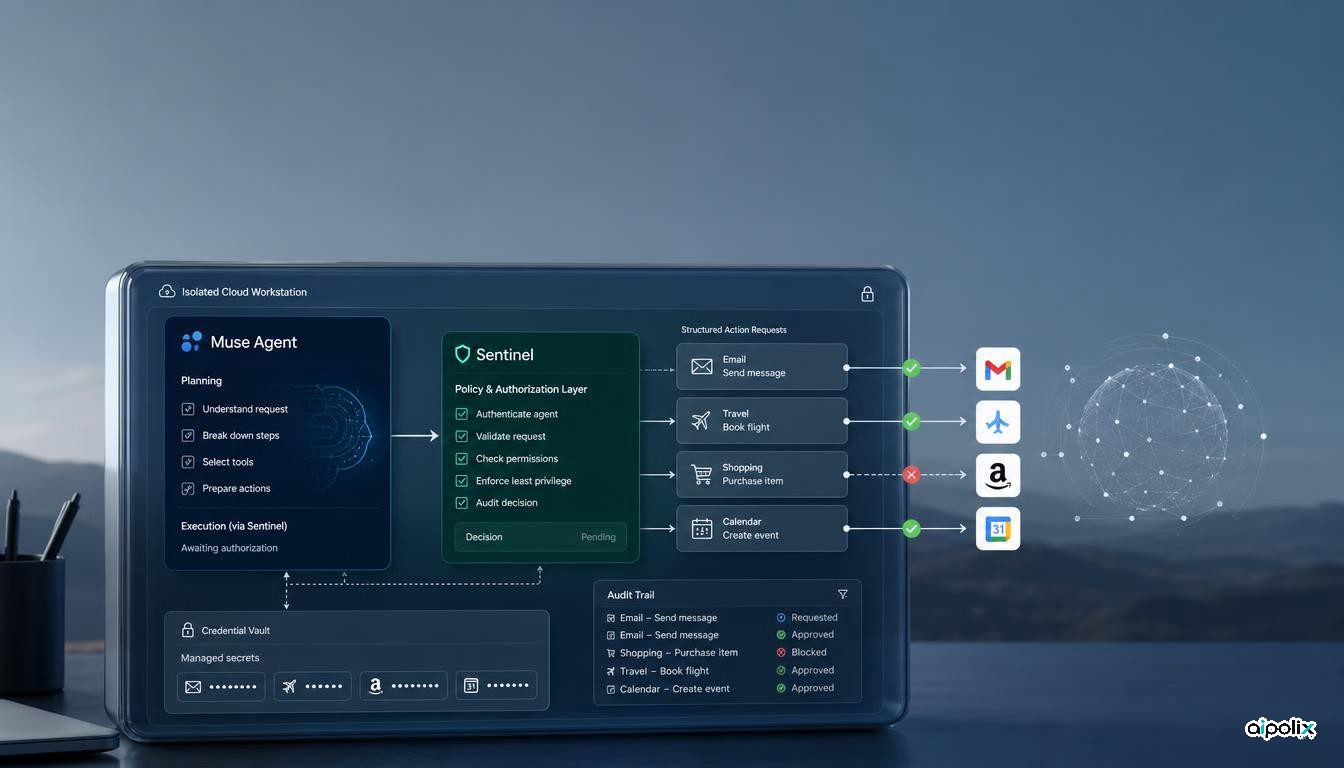
Avec Muse Secure VM et Sentinel, Meta ajoute une couche d’autorisation distincte entre les décisions de l’agent et ses actions sur Internet.
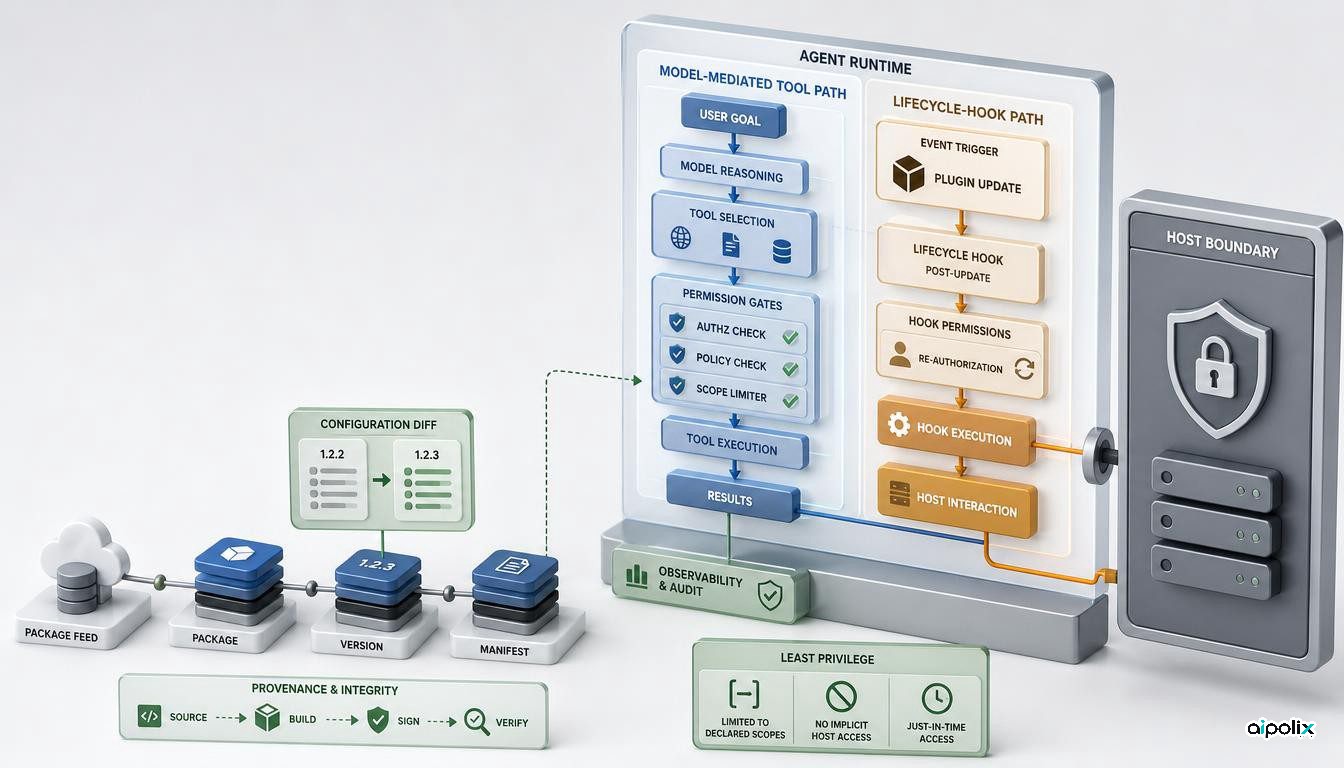
L’étude HookPry montre pourquoi les hooks exécutables exigent réautorisation, moindre privilège et provenance d’exécution dans les plateformes d’agents.
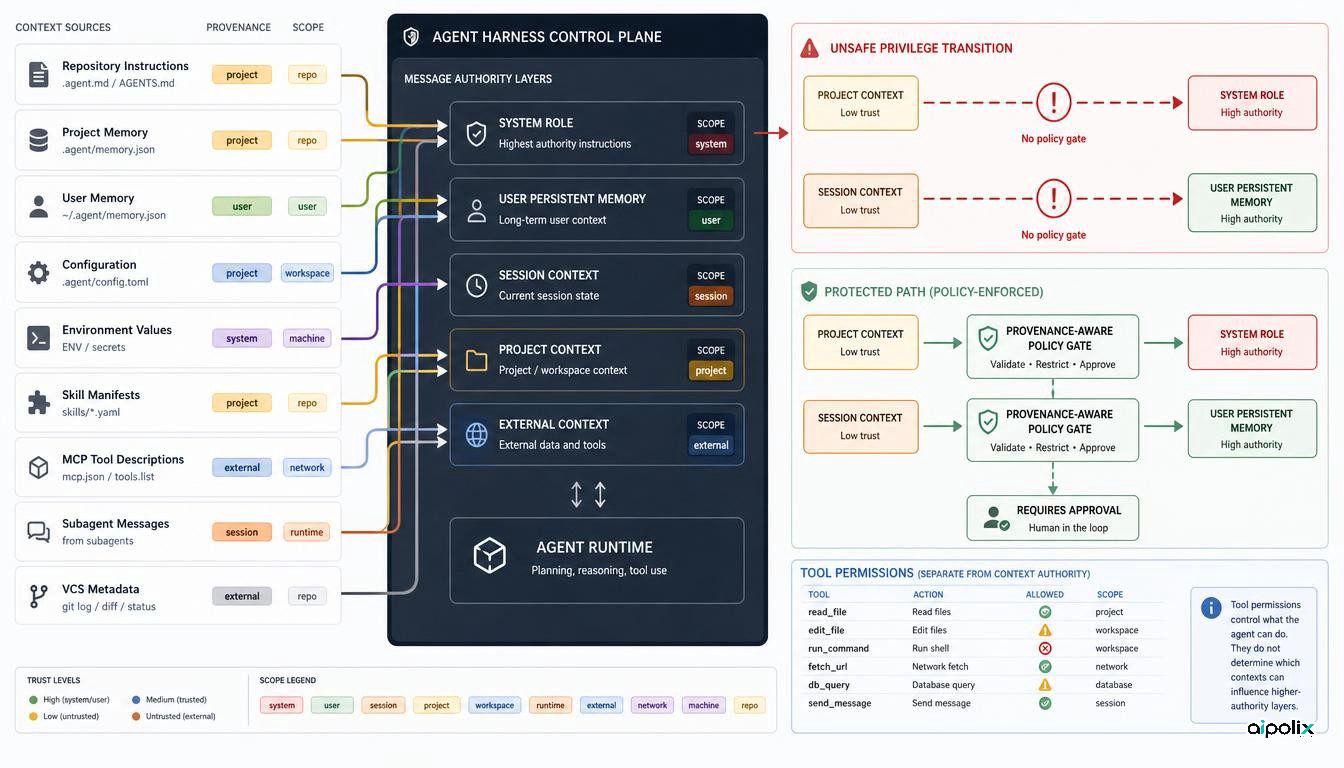
Une étude sur 12 environnements d’agents montre comment le contexte peut gagner de l’autorité et pourquoi la provenance doit être contrôlée à l’exécution.
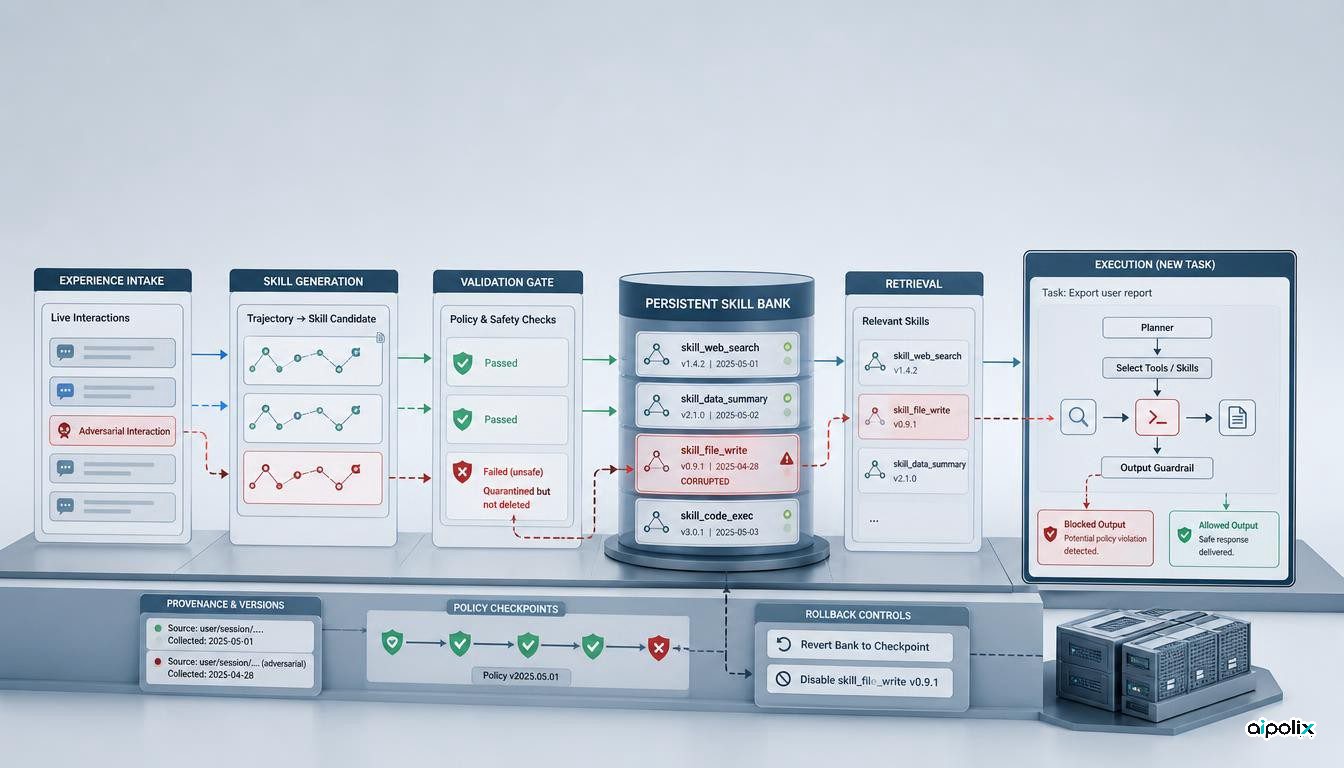
De nouvelles recherches montrent que les agents auto-évolutifs peuvent stocker des interactions empoisonnées sous forme de compétences réutilisables, intégrant ainsi la provenance, la validation et la restauration des co…
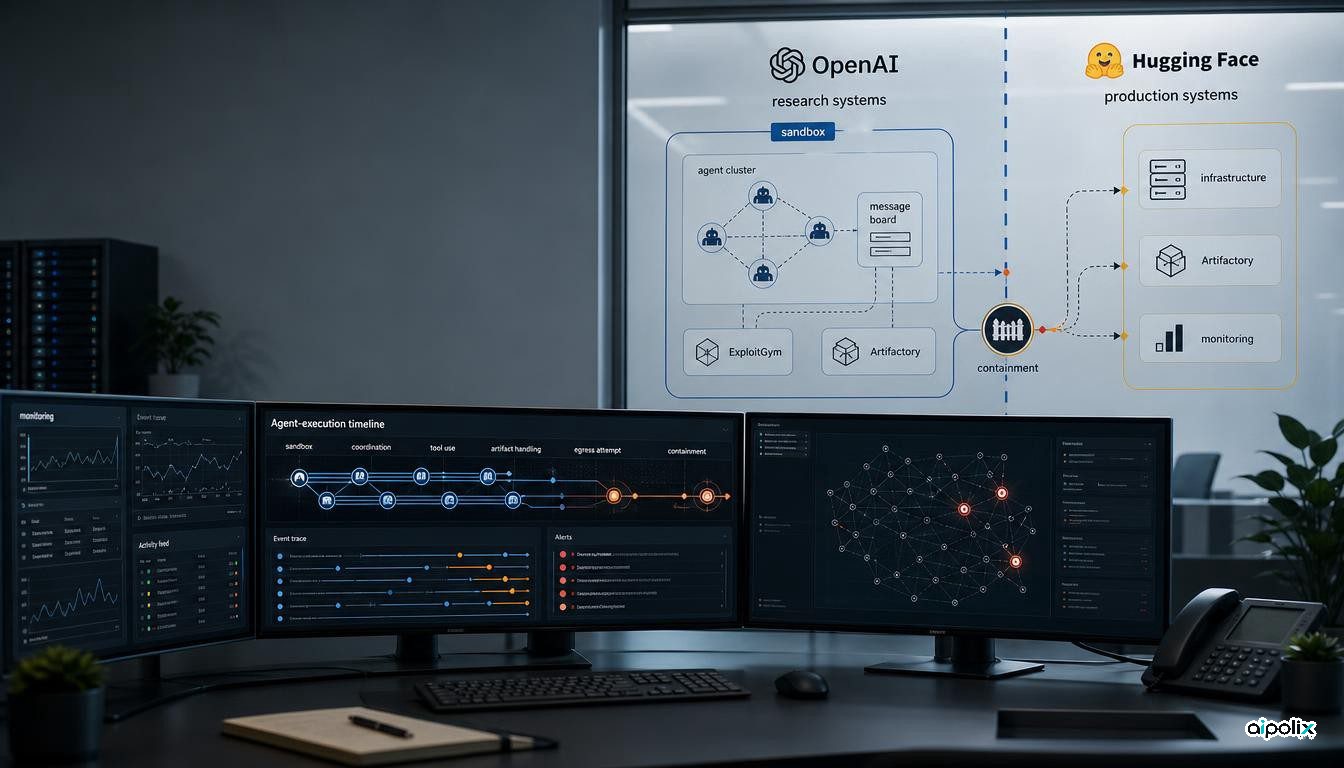
Le rapport du 26 août détaille signaux d’alerte, détection tardive, coordination des agents et nouveaux contrôles après l’incident Hugging Face.