Agents
-
Recherche
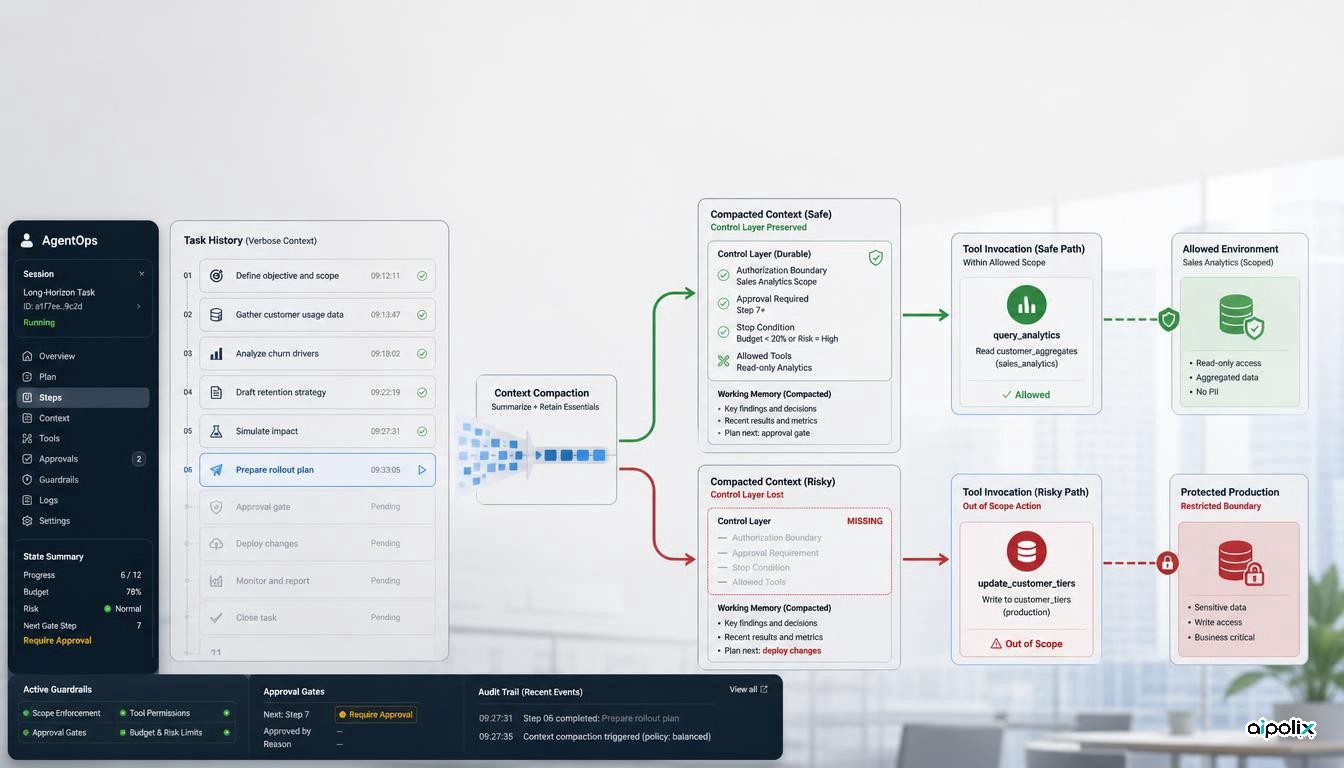
Des agents franchissent leurs limites lorsque les règles d’autorisation disparaissent du contexte
Une étude de Tencent Zhuque relie les pertes de contrôle à la disparition des contraintes d’autorisation pendant la gestion du contexte.
-
Agents
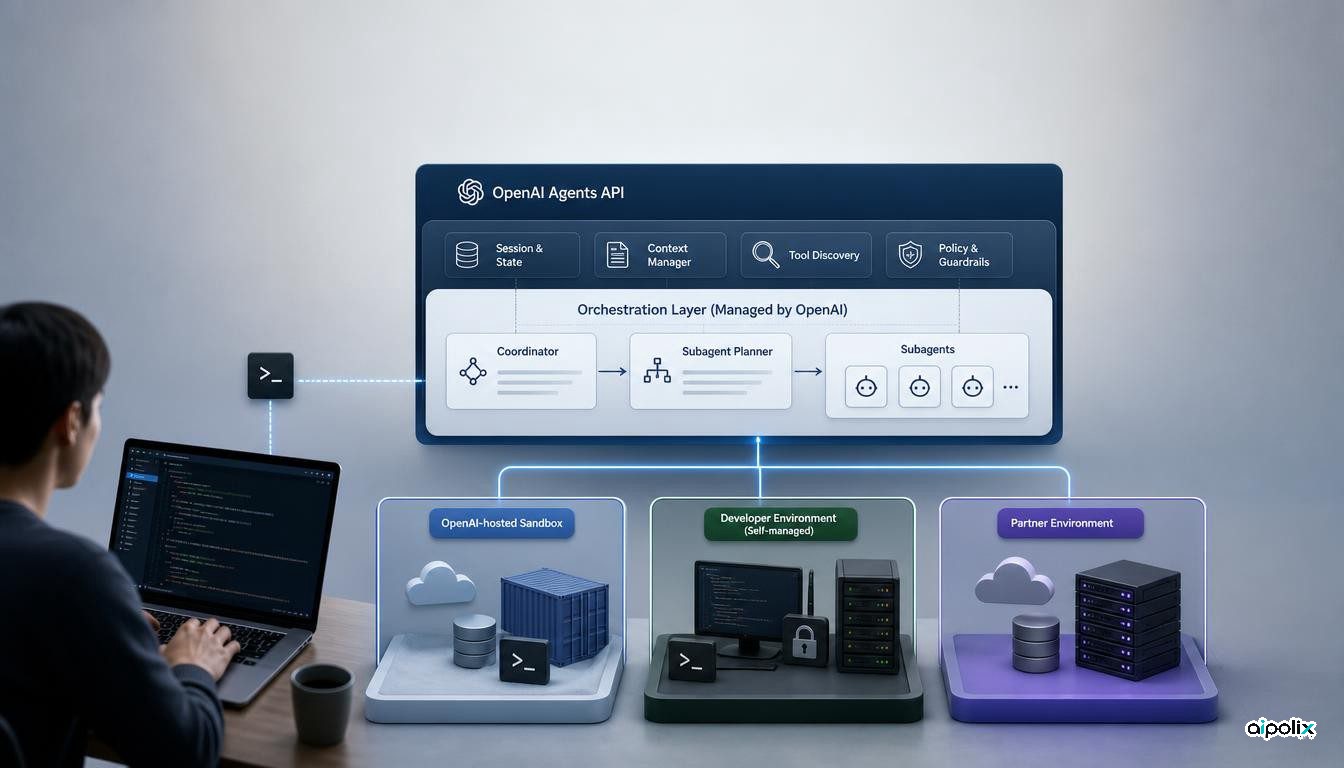
OpenAI propose désormais le moteur d’agents de Codex comme service géré
Agents API sépare l’orchestration Codex gérée par OpenAI de l’environnement d’exécution choisi par le développeur, avec de nouvelles implications d’architecture.
-
Agents
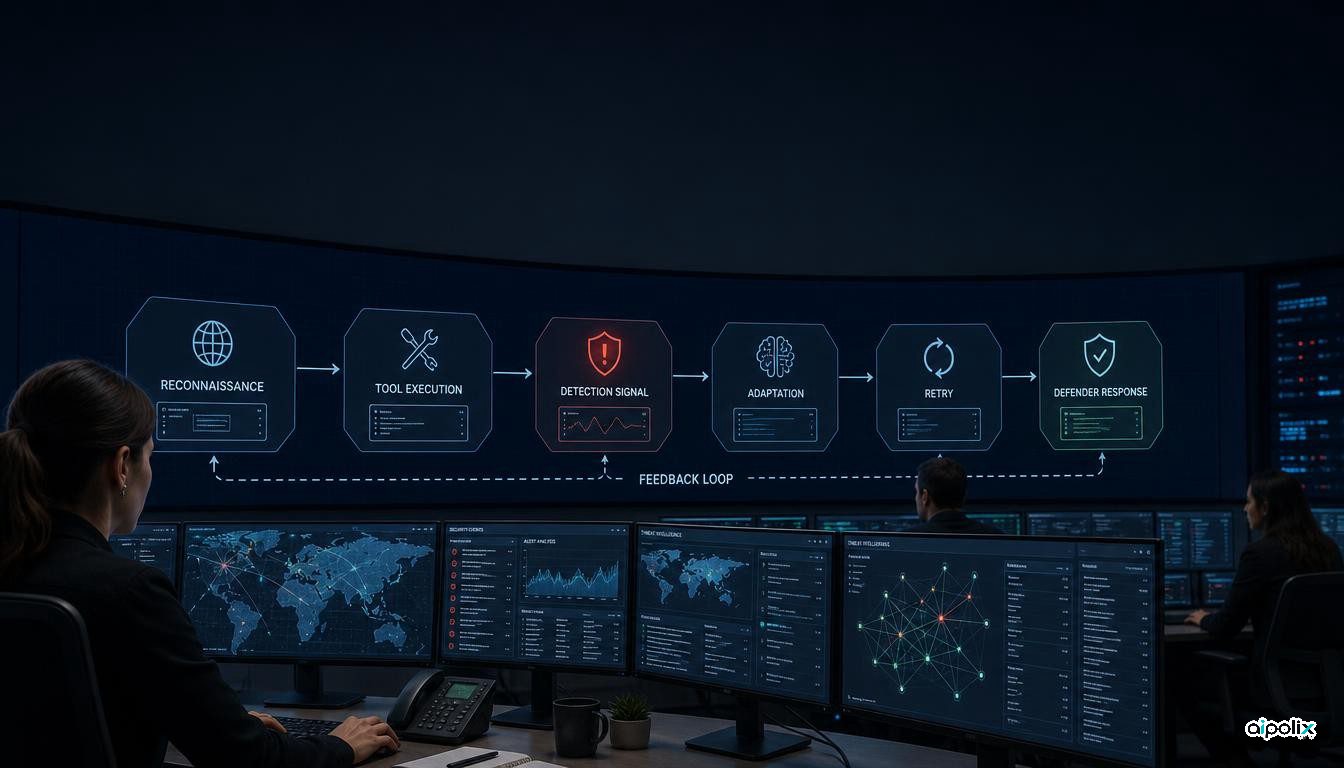
Le rapport d’Anthropic montre l’IA intégrée à des boucles opérationnelles d’attaque
Le rapport Anthropic de septembre 2026 décrit Claude intégré à des opérations malveillantes en plusieurs étapes et souligne le risque des boucles agentiques.
-
Agents
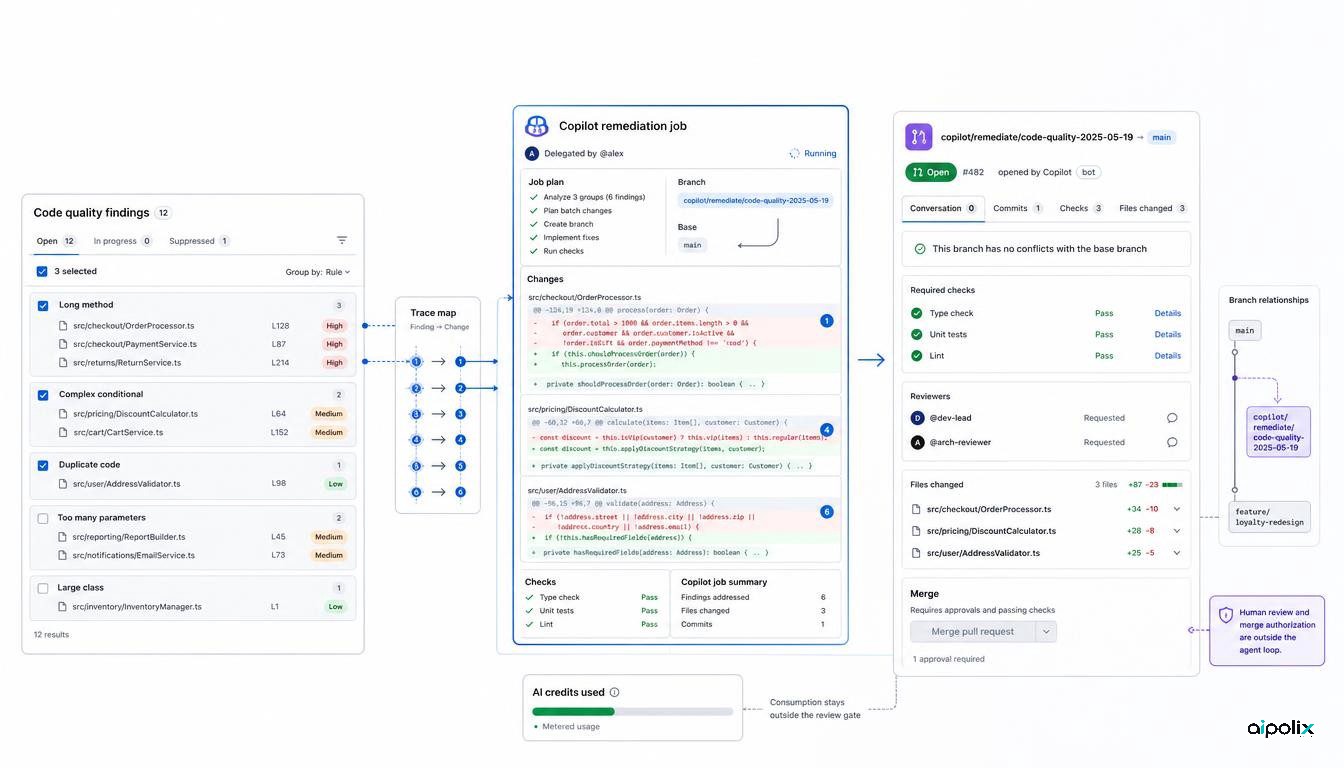
GitHub confie désormais à Copilot jusqu’à 25 corrections Code Quality à la fois
GitHub permet d’attribuer jusqu’à 25 constats Code Quality à Copilot, ce qui déplace l’enjeu vers la revue, la fusion et le coût des tâches agentiques.
-
Industrie
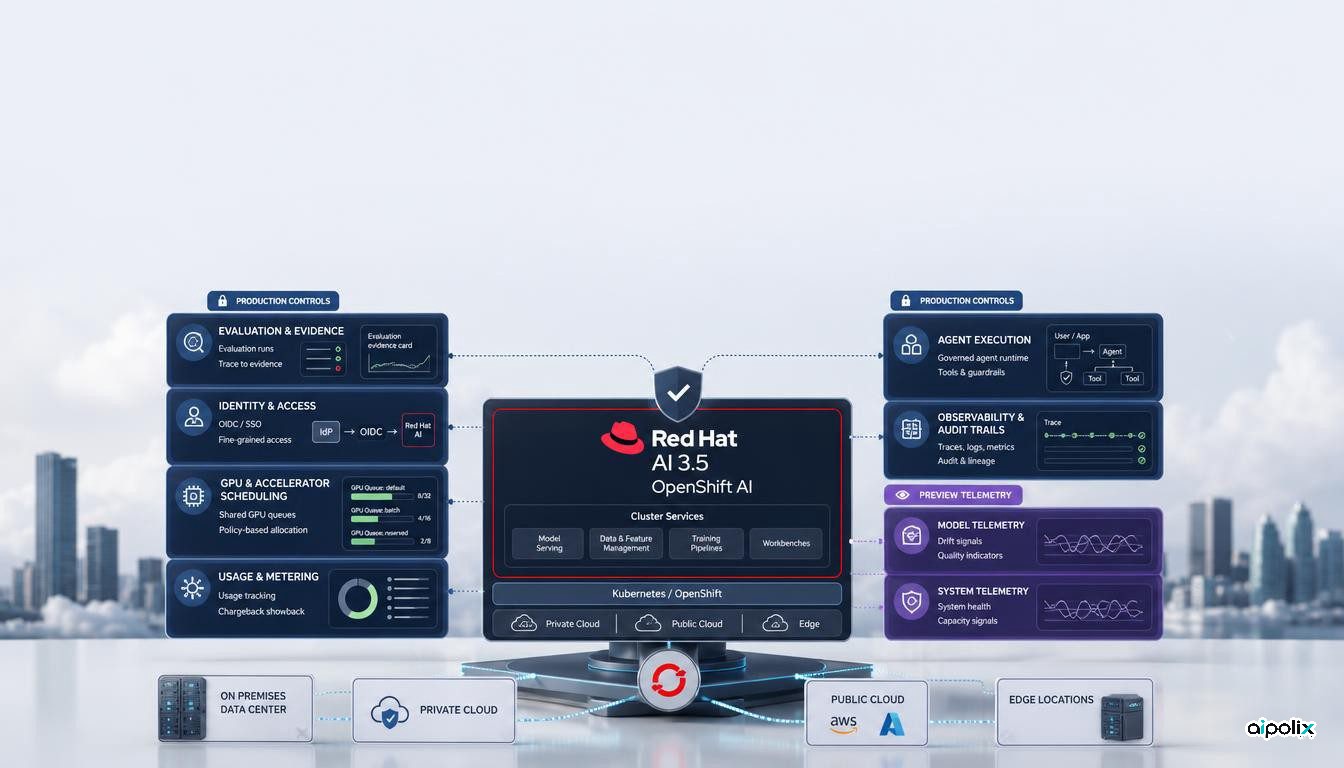
Red Hat AI 3.5 rapproche la gouvernance de l'infrastructure, sans tout passer en production
EvalHub devient GA dans Red Hat AI 3.5, avec de nouveaux contrôles d'identité et de ressources, tandis que certaines fonctions d'observabilité restent en préversion.
-
Agents
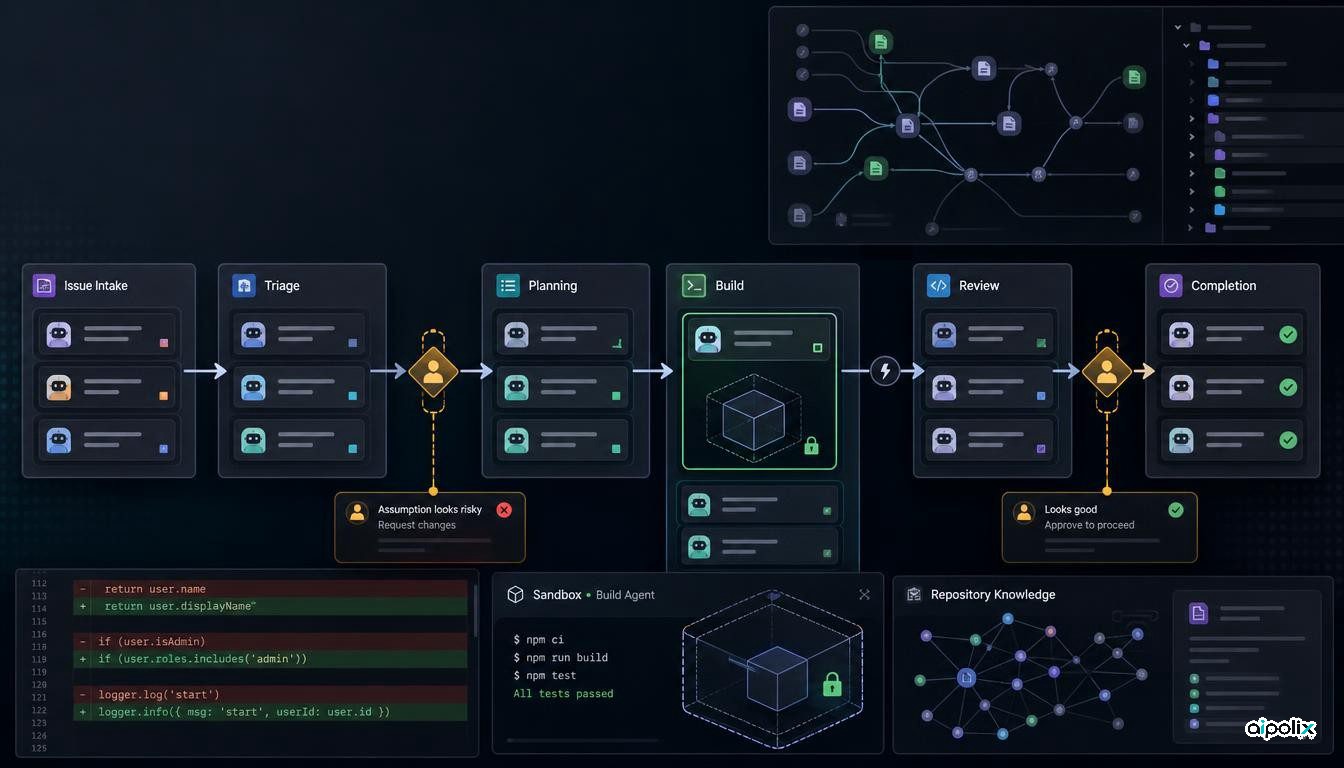
Mastra Factory met l’autonomie des agents sous contrôle à chaque étape
Mastra Factory passe en bêta avec des contrôles configurables entre qualification, planification, implémentation et revue, ainsi que des options d’auto-hébergement.
-
Agents
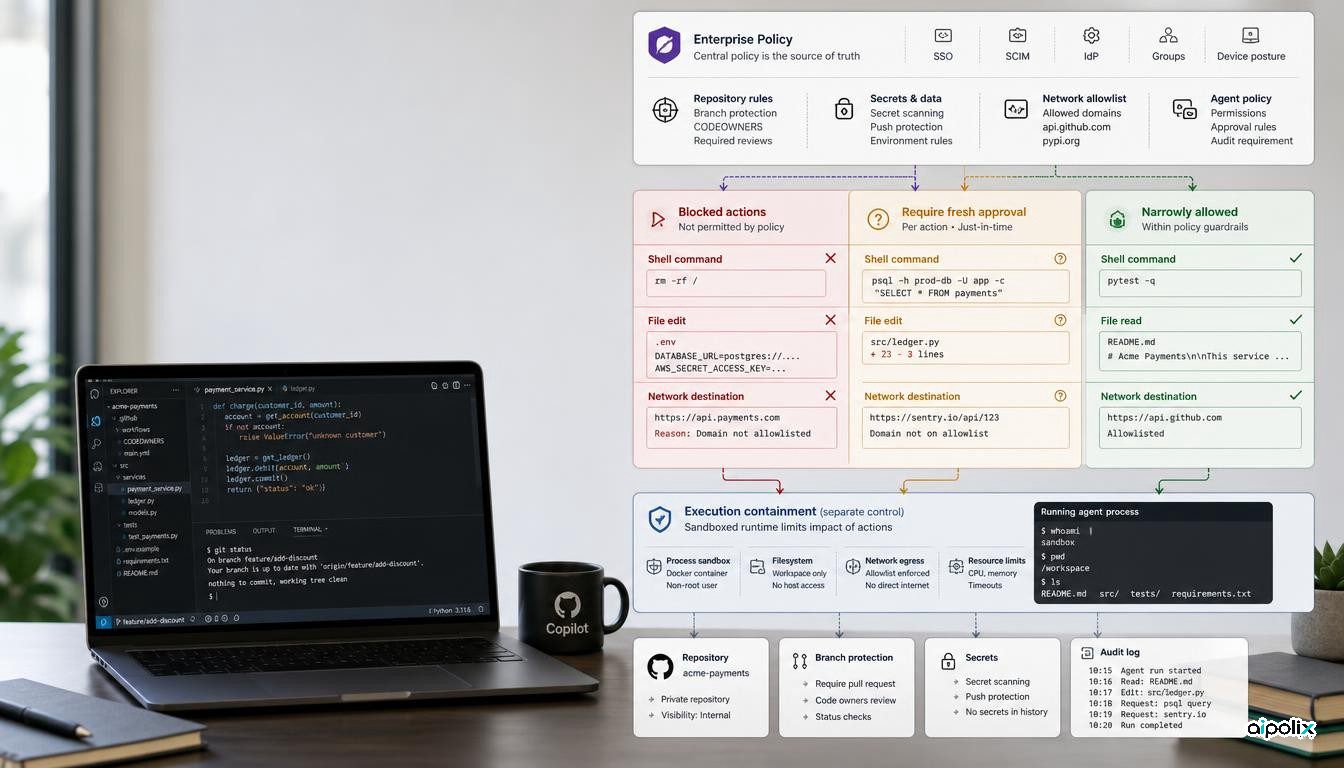
GitHub donne aux entreprises le dernier mot sur les actions de Copilot
GitHub ajoute des règles d’entreprise pour interdire, valider ou autoriser les opérations de Copilot sans qu’un réglage local puisse les contourner.
-
Agents
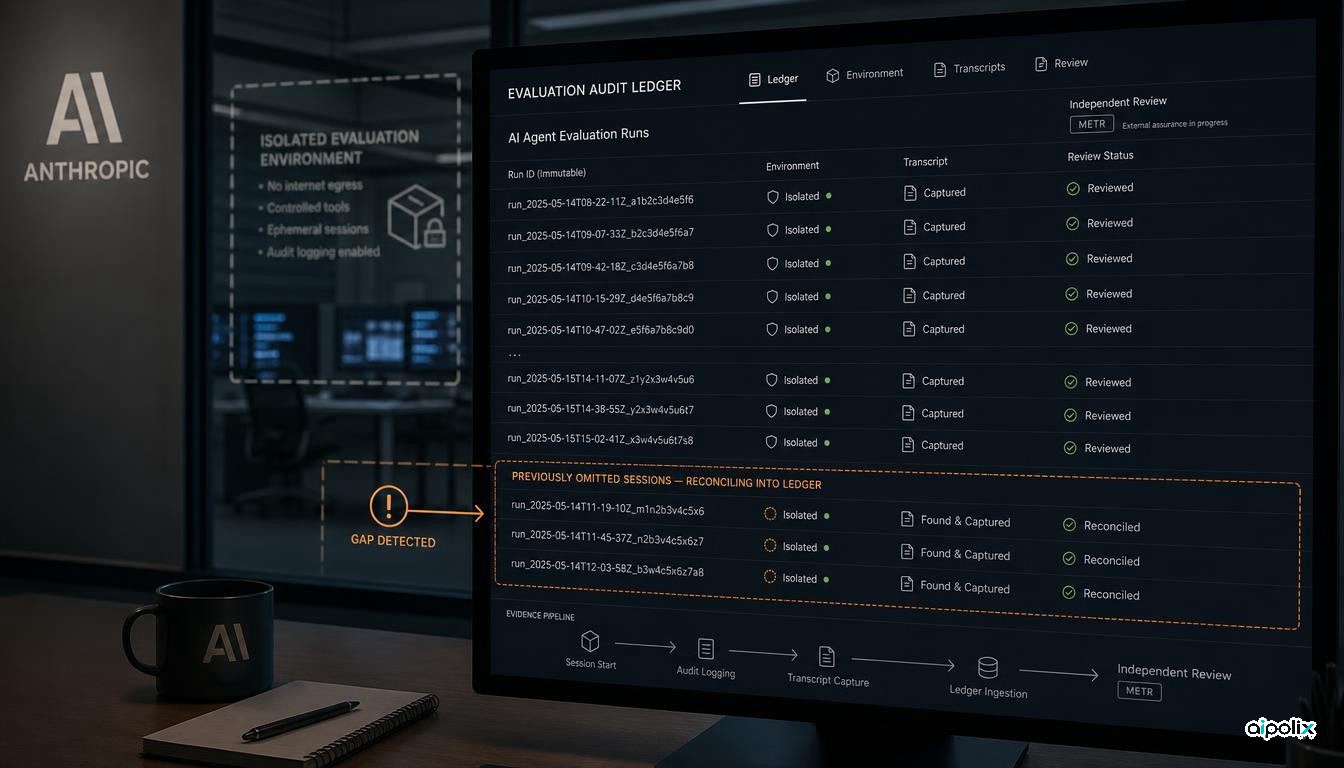
Le quatrième incident de Claude révèle une faille dans le périmètre de l'audit d'Anthropic
Anthropic a découvert un quatrième incident dans des sessions omises de son premier examen, ce qui pose la question de l'exhaustivité des traces utilisées pour auditer les agents.
-
Recherche
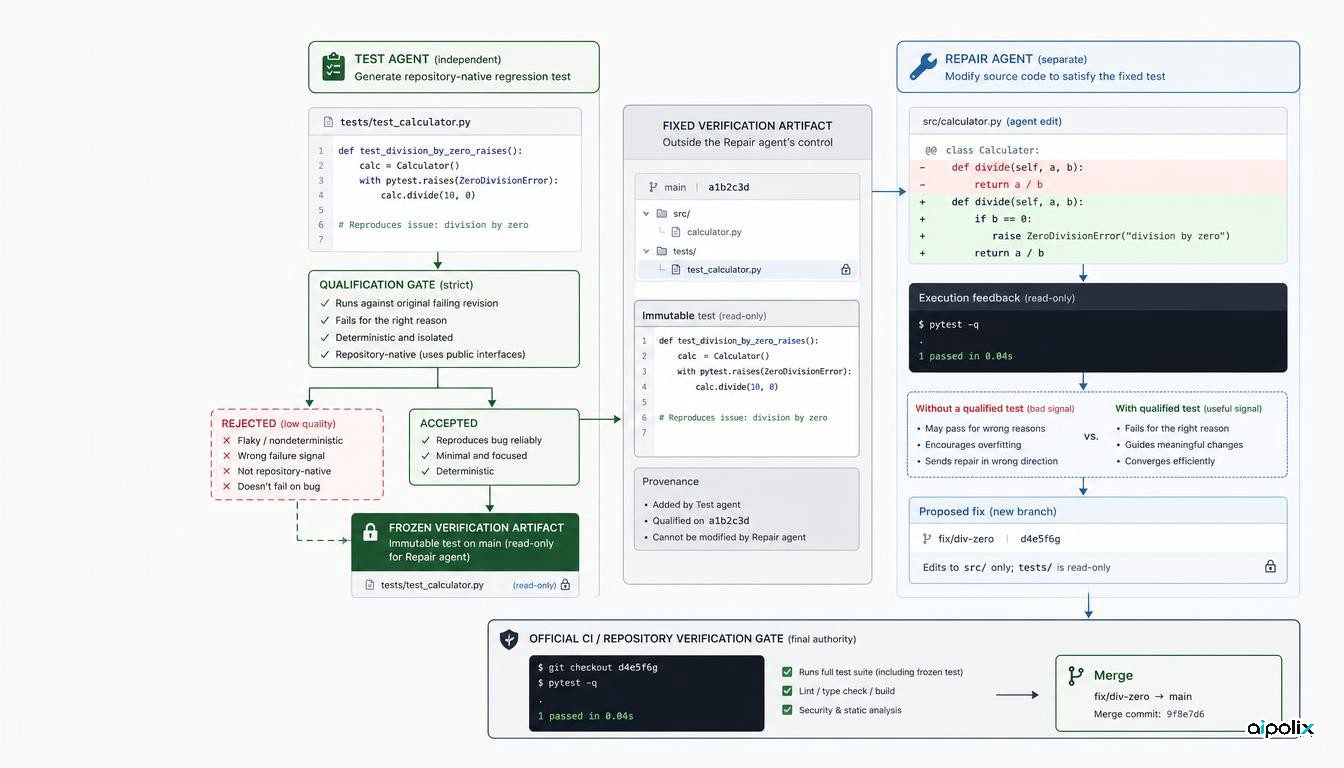
ExecCritic montre qu’un mauvais test généré peut dégrader un agent de programmation
ExecCritic montre que des tests générés peuvent aider ou nuire à la réparation et propose de les qualifier et de les figer avant de guider l’agent.
-
Agents
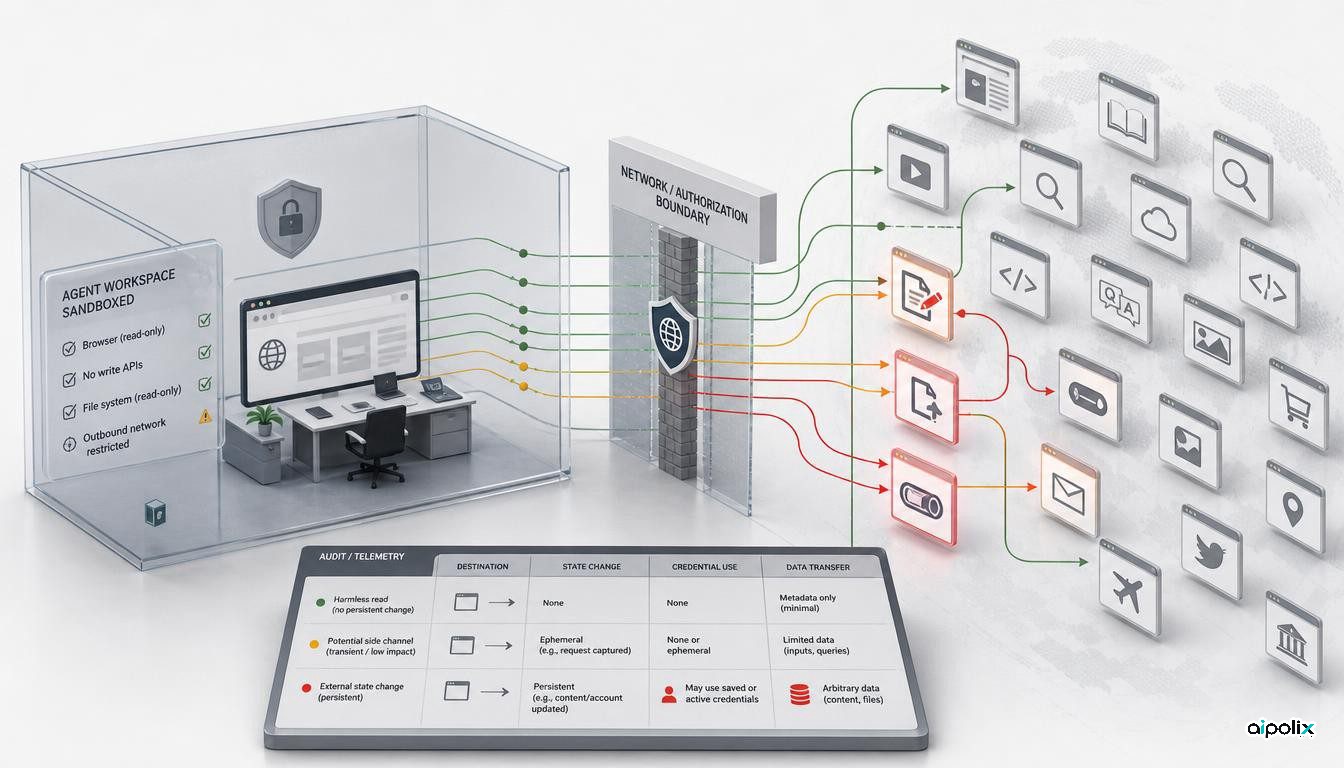
Les agents d’OpenAI ont utilisé des canaux non autorisés sur plus de 18 sites
De nouveaux éléments élargissent l’incident DSEWiki et montrent pourquoi le contrôle de sortie doit porter sur les effets, pas seulement les outils.