
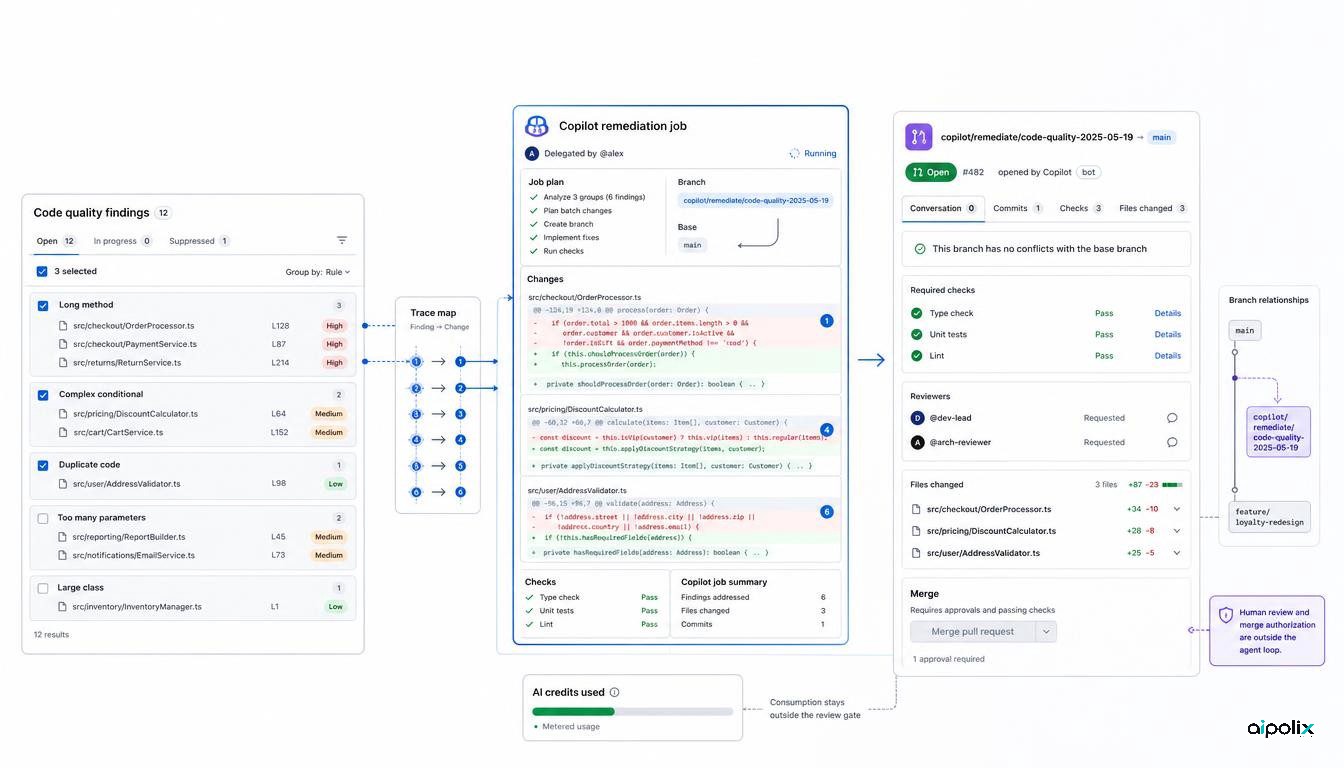
GitHub ajoute à Code Quality une correction par lots confiée à Copilot. Jusqu’à 25 constats standards peuvent être sélectionnés sur une page et attribués en une seule opération. Copilot travaille sur une branche, vérifie ses modifications puis ouvre une pull request destinée à être relue avant fusion.
La nouveauté ne consiste pas seulement à produire des correctifs plus vite. Une partie de la dette de qualité peut désormais être déléguée comme un lot de travail. Le point de contrôle principal se déplace donc de la génération d’une suggestion vers les tests, la revue et l’autorisation d’un ensemble de changements produits par l’agent.
Un lot de constats devient une tâche déléguée
GitHub indique que Assign to Copilot remplace l’ancien parcours Generate fix pour les constats individuels. Entre un et 25 éléments Code Quality peuvent être envoyés au cloud agent Copilot. La documentation Code Quality précise que le service analyse la branche par défaut pour détecter des problèmes de maintenabilité et de fiabilité et peut confier leur correction à Copilot.
L’unité de travail change donc. Au lieu d’un constat et d’un correctif, l’agent peut interpréter plusieurs problèmes, modifier plusieurs fichiers, exécuter des validations et livrer une seule pull request. Pour les équipes disposant d’un backlog important, les constats deviennent plus facilement une file de travaux exécutables.
La politique existante s’applique, mais l’acceptation doit rester séparée
GitHub précise que la correction agentique par lots reprend la politique d’entreprise existante de Code Quality et n’ajoute pas de réglage distinct. Chaque attribution à Copilot consomme également des crédits IA.
Cette continuité simplifie l’administration, mais le droit d’utiliser Code Quality n’est pas nécessairement équivalent au droit de produire un grand volume de changements. La validation effectuée par l’agent lui-même ne doit pas non plus être confondue avec une acceptation indépendante.
La pull request reste une frontière de contrôle utile. Protections de branche, tests obligatoires, règles de propriété du code et approbation humaine peuvent rester hors de la boucle de l’agent, même si la création de la branche et des correctifs lui est déléguée.
Les lots peuvent créer des erreurs corrélées
Un mauvais correctif isolé a généralement un impact limité. Dans un lot, une même hypothèse erronée peut toucher plusieurs constats lorsque ceux-ci concernent une abstraction commune, une configuration ou les tests.
L’analyse d’Aipolix est que l’équipe doit examiner le lot comme un travail délégué, et non comme 25 succès indépendants. La trace de revue devrait relier chaque constat initial à la modification correspondante, aux fichiers touchés, aux tests exécutés et aux interactions éventuelles entre correctifs.
C’est un effet classique de l’automatisation : augmenter le débit peut aussi accroître le rayon d’impact d’une mauvaise hypothèse. Une grande pull request sans traçabilité entre constat et changement rend ce risque plus difficile à diagnostiquer.
Les crédits transforment la remédiation en choix de ressources
Puisque les attributions consomment des crédits IA, la réduction de dette technique entre en concurrence avec d’autres usages du même budget agentique, notamment le développement, la sécurité et la revue.
Un backlog de milliers de constats ne doit pas automatiquement devenir des milliers de tâches. Les équipes peuvent prioriser selon le risque et le coût attendu de la revue, puis mesurer les correctifs réellement acceptés par crédit et par heure de relecture. Si les patches nécessitent beaucoup de reprises humaines, le volume de tâches lancées surestime la valeur réelle.
Une disponibilité large, mais conditionnelle
GitHub indique que la fonction est disponible pour les dépôts où Code Quality est activé sur GitHub Team et GitHub Enterprise Cloud, y compris les environnements avec résidence des données. Le cloud agent Copilot doit aussi être disponible pour le dépôt.
Cette portée permet un déploiement progressif. Une organisation peut tester le mécanisme sur quelques dépôts tout en conservant ses contrôles de fusion existants.
Ce qu’il faut mesurer
Le bon test n’est pas de savoir si Copilot traite 25 constats en une commande. Il faut mesurer le nombre de constats réellement résolus, les régressions, le temps de revue, la couverture des tests, les modifications hors périmètre, les crédits consommés et la fréquence à laquelle les lots doivent être découpés ou rejetés.
GitHub rapproche ainsi Code Quality d’un système de travail délégué plutôt que d’un simple générateur de suggestions. Le gain potentiel est une capacité d’exécution plus élevée, mais l’acceptation, le droit de fusion et la responsabilité budgétaire doivent rester hors de la décision de l’agent.